A prova do PAS 3 de 2018 deu quatro barras com o número de mulheres eleitas vereadoras (6,6; 6,5; 7,5 e 7,8 mil) e afirmou que o desvio padrão era inferior a 0,70; a de 2013 pediu, em resposta numérica, a variância de quatro barras da frota de veículos multiplicada por 100 (gabarito 135); a de 2023 falou em "variância amostral" e só fechava com o divisor n − 1; a de 2008 afirmou que três valores em progressão aritmética têm desvio padrão zero. Quanto os dados se afastam do centro, como medir esse afastamento com um número e o que ele permite concluir?
O que você vai aprender
Explicar por que a média não basta para descrever um conjunto de dados (dois conjuntos de mesma média e mediana podem ser opostos) e calcular a amplitude, reconhecendo que ela usa só os dois extremos.
Calcular os desvios em relação à média, conferir que a soma deles é zero e justificar por que a variância usa os quadrados dos desvios e não os desvios com sinal.
Calcular a variância populacional pela definição (média dos quadrados dos desvios) e pela fórmula alternativa (média dos quadrados menos o quadrado da média), e o desvio padrão como raiz quadrada, com a unidade certa em cada um.
Decidir entre o divisor n e o divisor n − 1 pela leitura do enunciado ("amostral" é a única senha para n − 1), prever o efeito de acrescentar um dado igual à média e resolver o item do PAS 3 de 2023 sobre a redução percentual da variância amostral.
Prever o que acontece com a média, a variância e o desvio padrão quando se soma uma constante a todos os dados ou se multiplicam todos por uma constante, inclusive em trocas de unidade e reajustes percentuais.
Comparar a regularidade de atletas, máquinas, turmas e séries pelo desvio padrão (menor é mais regular) e, quando as unidades ou escalas diferem, pelo coeficiente de variação (desvio padrão dividido pela média), conhecendo os limites dessa razão.
Calcular a variância de dados agrupados numa tabela de frequências, ler os valores certos de um gráfico de barras ou de linhas antes de calcular, interpretar histogramas concentrados e espalhados e o intervalo de um desvio padrão em torno da média (com a regra 68–95–99,7 para a curva em sino).
Resolver os itens do PAS nos formatos A (limiar comparado com o quadrado da variância), B (variância com fator de escala) e C (variância em faixas), e evitar os erros clássicos: raiz esquecida, divisor errado, desvio padrão negativo, unidade da variância, amplitude como dispersão total.
Em 2018, a prova do PAS 3 mostrou dois gráficos do Tribunal Superior Eleitoral com os candidatos a vereador no Brasil nas eleições de 2004, 2008, 2012 e 2016, separados em homens e mulheres, e afirmou que “o desvio padrão da sequência dos números de mulheres eleitas vereadoras nas eleições de 2004 a 2016 é inferior a 0,70”: quatro barras (6,6; 6,5; 7,5 e 7,8 mil), uma média, quatro desvios, uma raiz quadrada e um limiar colado no resultado. Cinco anos antes, com a frota de veículos por 100 habitantes de 2000 a 2012 num gráfico, a mesma etapa pediu em resposta numérica “a variância dos dados referentes ao período de 2000 a 2003”, multiplicada por 100 (o gabarito foi 135). Em 2023, um item de resposta numérica falou em “variância amostral” e só fechava com o divisor n−1; em 2008, outro afirmou que três valores em progressão aritmética têm desvio padrão igual a zero. Os quatro itens giram em torno de uma pergunta que a média, a mediana e a moda não respondem: quanto os dados se afastam do centro, como medir esse afastamento com um número e o que ele permite concluir?
Esta página é a segunda metade do resumo de um conjunto de dados. A página anterior escolheu um número para o centro; esta escolhe um número para o espalhamento. A medida mais simples é a amplitude, que só olha as duas pontas do conjunto. A mais usada é o desvio padrão, construído em quatro passos que a prova cobra na ordem: calcular a média, subtrair a média de cada dado (os desvios), elevar os desvios ao quadrado e tirar a média dos quadrados (a variância), e por fim extrair a raiz quadrada para voltar à unidade dos dados. Ao redor desse roteiro ficam as perguntas que viram item: por que elevar ao quadrado, por que às vezes se divide por n−1, o que acontece quando todos os dados ganham ou são multiplicados por uma constante, como comparar a regularidade de dois conjuntos com médias diferentes (o coeficiente de variação) e como ler a dispersão num gráfico ou numa tabela de frequências.
Mesma média, histórias diferentes: por que o centro não basta
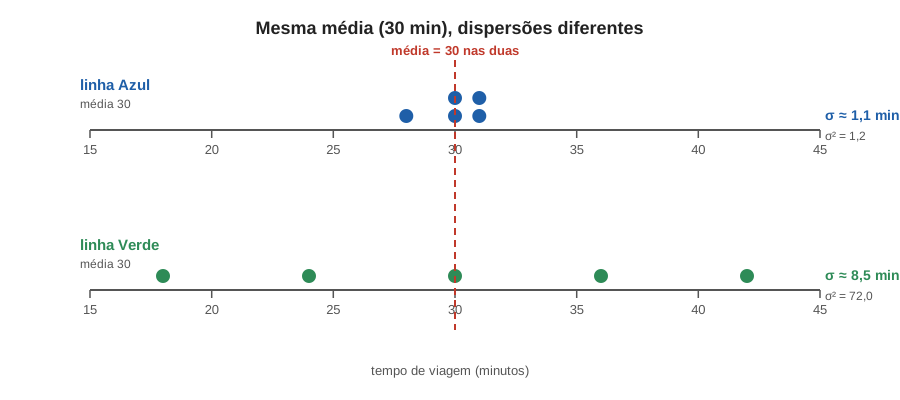
Duas linhas de ônibus ligam o mesmo bairro ao centro da cidade. Durante cinco dias, uma passageira cronometrou a viagem em cada uma. Na linha Azul, os tempos foram 28, 30, 30, 31 e 31 minutos; na linha Verde, 18, 24, 30, 36 e 42 minutos. As duas somam 150 minutos em cinco viagens e têm, portanto, a mesma média, 30 minutos. A mediana também é 30 nas duas. Se o resumo parasse no centro, as linhas seriam idênticas, e qualquer pessoa que já pegou as duas sabe que não são: na Azul, a viagem dura “uns 30 minutos” todos os dias; na Verde, pode durar 18 ou 42, e quem tem hora marcada precisa sair com folga de doze minutos.
As duas linhas têm média 30 minutos e mediana 30 minutos, e nada mais em comum: a Azul concentra os tempos a um ou dois minutos do centro, a Verde os espalha até doze minutos para cada lado. O desvio padrão (1,1 contra 8,5 minutos) é o número que separa as duas. Diagrama autoral.
O que distingue as linhas é a dispersão: o quanto os dados se afastam do centro. Toda medida de dispersão é uma resposta à pergunta “quão longe da média os dados costumam ficar”, e há mais de uma maneira de respondê-la. A primeira, e a mais crua, é olhar só para as pontas.
Amplitude
A amplitude de um conjunto de dados mede a distância entre as duas pontas: o maior valor menos o menor,
A=xmax−xmin.
Tem a unidade dos dados, é zero quando todos os dados são iguais e cresce quando as pontas se afastam. Linha Azul: 31−28=3 minutos; linha Verde: 42−18=24 minutos.
A amplitude é fácil e é pobre: ela usa dois dados e ignora todos os outros. Dois conjuntos de sete notas, 10,20,20,20,20,20,30 e 10,10,10,20,30,30,30, têm a mesma média (20) e a mesma amplitude (20), mas o primeiro tem cinco dados exatamente na média e o segundo não tem nenhum: o segundo é muito mais espalhado, e a amplitude não vê isso. Basta também um único dado fora da curva (um erro de digitação, um dia de greve) para a amplitude disparar sem que o resto do conjunto tenha mudado. Para medir o espalhamento de todos os dados, é preciso olhar para a distância de cada um deles até a média.
Desvio em relação à média: a soma é sempre zero
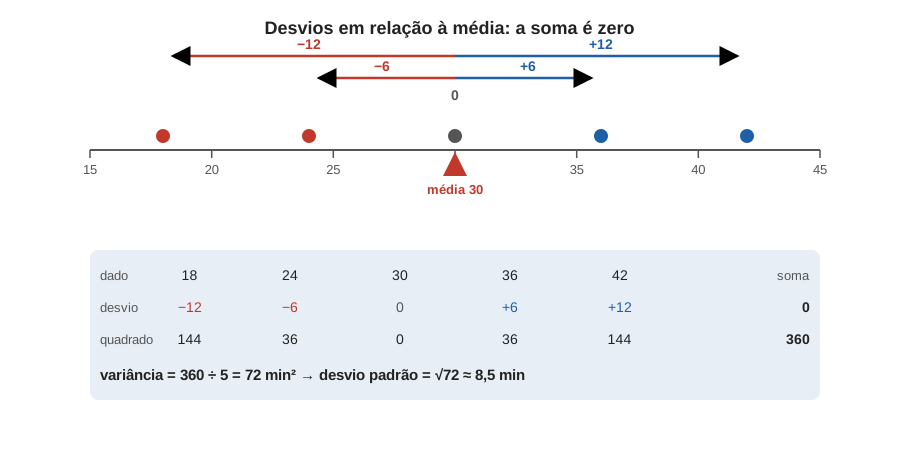
Para cada dado, calcule a diferença entre ele e a média. Essa diferença é o desvio do dado. Na linha Verde (média 30), os desvios são 18−30=−12, 24−30=−6, 30−30=0, 36−30=+6 e 42−30=+12. O sinal diz de que lado da média o dado está, e o valor absoluto diz a que distância.
Os desvios da linha Verde em relação à média 30. Os negativos (à esquerda) e os positivos (à direita) se cancelam na soma, que dá zero em qualquer conjunto de dados; elevados ao quadrado, todos ficam positivos e os maiores pesam mais. A média dos quadrados, 360÷5=72, é a variância. Diagrama autoral.
A primeira ideia para medir a dispersão seria tirar a média dos desvios. Ela não funciona, e a razão é um fato que vale para qualquer conjunto de dados: a soma dos desvios em relação à média é sempre zero. Na linha Verde, −12−6+0+6+12=0; na Azul, os desvios são −2,0,0,+1,+1, e a soma é zero de novo. Isso não é coincidência. Somar os n desvios é somar os n dados e subtrair n vezes a média:
∑(xi−xˉ)=∑xi−nxˉ=nxˉ−nxˉ=0,
porque a soma dos dados é, por definição de média, nxˉ. A média é o ponto de equilíbrio dos dados, e os desvios para um lado compensam exatamente os desvios para o outro. Esse fato tem duas utilidades práticas. A primeira é uma conferência que custa dez segundos: calculados os desvios, some-os; se a soma não der zero, a média está errada ou houve erro numa subtração, e nada do que vem depois se aproveita. A segunda é que ele obriga a escolher o que fazer com os sinais.
Há dois caminhos. Um é ignorar o sinal e tirar a média dos valores absolutos dos desvios, o que produz o desvio médio absoluto: na linha Verde, (12+6+0+6+12)÷5=7,2 minutos; na Azul, (2+0+0+1+1)÷5=0,8 minuto. É uma medida legítima, raramente usada em prova. O outro caminho, o que a estatística adotou, é elevar cada desvio ao quadrado. O quadrado também apaga o sinal (todo quadrado é positivo ou zero), mas faz algo a mais: ele amplia os desvios grandes em relação aos pequenos. Um desvio de 12 vira 144; um desvio de 6 vira 36; o primeiro passa a pesar quatro vezes o segundo, e não duas. A medida resultante é sensível a dados muito afastados, o que é exatamente o que se espera de uma medida de espalhamento, e tem propriedades algébricas que o valor absoluto não tem (a fórmula alternativa da próxima seção é uma delas).
Variância: a média dos quadrados dos desvios
Variância (populacional)
Para n dados x1,x2,…,xn de média xˉ, a variância é a média dos quadrados dos desvios:
Lê-se “sigma ao quadrado”. A variância é sempre maior ou igual a zero, e só é zero quando todos os dados são iguais à média, isto é, iguais entre si. A sua unidade é a unidade dos dados ao quadrado: minutos ao quadrado, reais ao quadrado, quilogramas ao quadrado.
Exemplo resolvido 1: as duas linhas de ônibus. Linha Verde: média 30, desvios −12,−6,0,6,12 (soma zero), quadrados 144,36,0,36,144, soma 360, variância σ2=360÷5=72 min². Linha Azul: média 30, desvios −2,0,0,1,1 (soma zero), quadrados 4,0,0,1,1, soma 6, variância σ2=6÷5=1,2 min². A variância da Verde é sessenta vezes a da Azul. O número em si (72) não diz muito, porque está numa unidade estranha; a comparação entre os dois, sim.
O roteiro do exemplo é o de toda conta de variância, e vale a pena fixá-lo como uma tabela de quatro colunas: dado, desvio, quadrado do desvio, e as somas. A coluna dos desvios tem de somar zero; a dos quadrados, dividida por n, é a variância. Numa prova sem calculadora, é esse arranjo que evita perder um sinal ou um quadrado.
A fórmula alternativa. Existe um segundo modo de calcular a mesma variância, sem passar pelos desvios: tirar a média dos quadrados dos dados e subtrair o quadrado da média.
σ2=n∑xi2−xˉ2.
A demonstração é um desenvolvimento de quadrado. Cada (xi−xˉ)2 é xi2−2xixˉ+xˉ2; somando sobre os n dados, ∑xi2−2xˉ∑xi+nxˉ2. Como ∑xi=nxˉ, o termo do meio é −2nxˉ2, e a soma fica ∑xi2−nxˉ2. Dividindo por n, aparece a fórmula. Na linha Verde: 182+242+302+362+422=324+576+900+1296+1764=4860; dividido por 5, 972; menos 302=900, dá 72. Confere. A fórmula alternativa é útil quando a média é um decimal feio (os desvios ficam feios e os quadrados, piores) e quando o enunciado dá a soma dos dados e a soma dos quadrados em vez da lista; é também o que permite recuperar uma informação escondida, como a seção sobre dispersão em contexto mostra com um item do ENEM.
O divisor da variância
Na variância, a soma dos quadrados é dividida pelo número de dados, n. Há três maneiras de errar essa divisão. Dividir pela soma dos dados (confundir n com ∑xi). Numa tabela de frequências, dividir pelo número de linhas em vez de pelo total de observações (a seção de dados agrupados trata disso). E dividir por n−1 sem que o enunciado peça: o divisor n−1 é a variância amostral, uma medida diferente, com nome próprio, que a prova só usa quando escreve “amostral” (a seção seguinte à do desvio padrão explica o porquê). Quando o enunciado diz só “variância” ou “desvio padrão”, o divisor é n.
Desvio padrão: de volta à unidade dos dados
A variância da linha Verde é 72 minutos ao quadrado, e ninguém sabe o que é um minuto ao quadrado. Para voltar à unidade dos dados, desfaz-se o quadrado com uma raiz.
Desvio padrão
O desvio padrão é a raiz quadrada da variância:
σ=σ2=n∑(xi−xˉ)2.
Tem a mesma unidade dos dados e pode ser lido como a “distância típica” entre um dado e a média: um conjunto com desvio padrão 8 minutos é um conjunto em que os dados ficam, tipicamente, a uns 8 minutos da média. É sempre maior ou igual a zero (uma raiz quadrada nunca é negativa) e só é zero quando todos os dados são iguais.
Linha Verde: σ=72≈8,5 minutos. Linha Azul: σ=1,2≈1,1 minuto. Agora os números falam a língua do problema: na Verde a viagem costuma desviar uns oito minutos e meio dos 30; na Azul, um minuto. Repare que o desvio padrão não é o desvio médio absoluto (7,2 e 0,8) nem a metade da amplitude: é uma medida própria, que pesa mais os afastamentos grandes, e por isso fica um pouco acima do desvio médio absoluto em quase todo conjunto.
Raízes sem calculadora. A prova do PAS não dá calculadora, e os itens de desvio padrão têm um limiar: “inferior a 0,70”, “superior a 6%”. Quase nunca é preciso extrair a raiz. Para saber se σ é menor que 0,70, basta saber se σ2 é menor que 0,702=0,49; para saber se σ>6, basta saber se σ2>36. Comparar a variância com o quadrado do limiar é mais rápido e mais seguro que aproximar uma raiz. Quando o valor em si é pedido, guarde algumas raízes de referência: 2≈1,41, 3≈1,73, 5≈2,24, 10≈3,16, e a regra de que a×100=10a (72=36×2=62≈8,49).
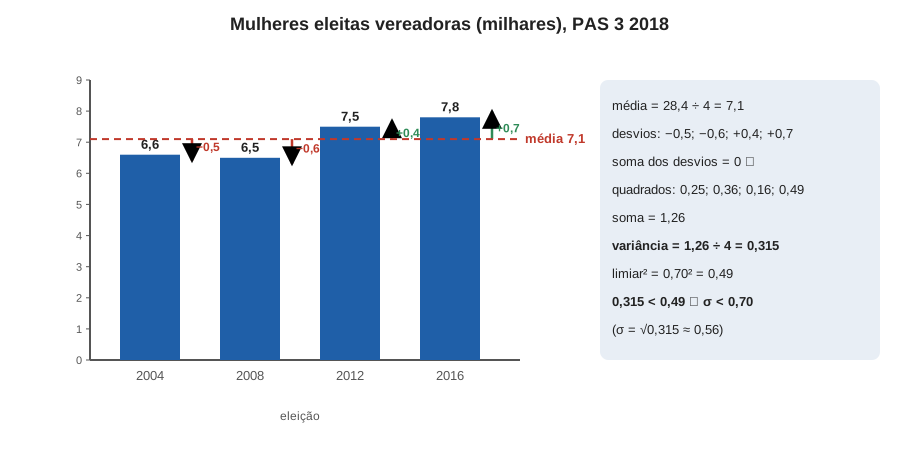
Exemplo resolvido 2: as vereadoras eleitas (PAS 3 2018). O gráfico do TSE impresso na prova trazia, em milhares, o número de mulheres eleitas vereadoras: 6,6 em 2004; 6,5 em 2008; 7,5 em 2012; 7,8 em 2016 (e, de homens, 45,2; 45,3; 49,7 e 50,0). O item afirmou que “o desvio padrão da sequência dos números de mulheres eleitas vereadoras nas eleições de 2004 a 2016 é inferior a 0,70”. Média: (6,6+6,5+7,5+7,8)÷4=28,4÷4=7,1. Desvios: −0,5; −0,6; +0,4; +0,7 (soma: −1,1+1,1=0, confere). Quadrados: 0,25; 0,36; 0,16; 0,49; soma 1,26. Variância: 1,26÷4=0,315. O limiar ao quadrado é 0,702=0,49, e 0,315<0,49; logo σ<0,70. Certo. (A raiz, se alguém quiser, é σ≈0,56.) Conferência pela fórmula alternativa:6,62+6,52+7,52+7,82=43,56+42,25+56,25+60,84=202,90; dividido por 4, 50,725; menos 7,12=50,41, dá 0,315. A unidade do desvio padrão é a dos dados, milhares de vereadoras; o 0,70 do item são 700 vereadoras.
As quatro barras do item do PAS 3 de 2018 (mulheres eleitas vereadoras, em milhares) e a linha da média, 7,1. Os desvios somam zero; os quadrados somam 1,26; a variância é 0,315. Como 0,315<0,702=0,49, o desvio padrão é inferior a 0,70 sem que seja preciso extrair a raiz. Diagrama autoral com os dados do gráfico do TSE impresso na prova.
O exemplo mostra o item típico de desvio padrão: os dados vêm de um gráfico de barras ou de linhas, são quatro ou cinco valores com uma casa decimal, a média é limpa e o limiar fica perto do resultado. A conta é a mesma sequência de sempre, e a única decisão é não extrair a raiz.
Populacional ou amostral: quando dividir por n − 1
A variância definida acima descreve um conjunto de dados que é tudo o que interessa: as cinco viagens cronometradas, as quatro eleições, as notas de uma turma. Chama-se variância populacional, e o seu divisor é n. Há uma segunda definição, que divide pela quantidade de dados menos um.
Variância e desvio padrão amostrais
Quando os n dados são uma amostra de uma população maior e o objetivo é estimar a dispersão dessa população, usa-se a variância amostral
s2=n−1∑(xi−xˉ)2,
e o desvio padrão amostrals=s2. A soma dos quadrados dos desvios é a mesma; só o divisor muda. Como n−1<n, a variância amostral é sempre um pouco maior que a populacional calculada com os mesmos dados, e a diferença é tanto menor quanto maior for n: para 4 dados, s2=34σ2; para 100 dados, s2≈1,01σ2.
O motivo da correção pode ser dito sem fórmulas. A média da amostra não é a média da população; é a média dos dados que se tem, e os dados ficam, em conjunto, mais perto da própria média do que de qualquer outro número, inclusive da média verdadeira da população. Por isso a soma dos quadrados, medida a partir da média da própria amostra, sai sistematicamente pequena, e dividir por n−1 em vez de n compensa esse encolhimento. (Outra maneira de ver: os n desvios somam zero, logo só n−1 deles são livres; o último está determinado pelos outros.) Para a prova, o que importa é a regra de leitura: o divisor é n−1 apenas quando o enunciado diz “amostral” ou define a fórmula com n−1. “Variância”, “desvio padrão” e “dispersão” sem adjetivo são populacionais, com divisor n. Os gabaritos dos itens do PAS confirmam a regra nos dois sentidos: o item de 2013 que pediu “a variância” das frotas de 2000 a 2003 só fecha com divisor 4, e o item de 2023 que falou em “variância amostral” só fecha com divisor n−1.
Exemplo resolvido 3: a variância amostral que encolhe (PAS 3 2023). O gráfico I da prova trazia a população de imigrantes mexicanos nos Estados Unidos, em milhões, por década: 4,28 em 1990; 9,16 em 2000; 11,73 em 2010. O item pediu: “Considere que, entre 1990 e 2020, a média aritmética de imigrantes mexicanos para os EUA tenha sido igual à observada entre 1990 e 2010 e que, portanto, entre 1990 e 2020, a variância amostral entre 1990 e 2020 tenha sido p% menor que a variância amostral entre 1990 e 2010. Com base nesse cenário hipotético, calcule o valor de p.” A hipótese diz que, acrescentando o dado de 2020, a média não muda; isso só acontece se o dado novo for igual à média dos três anteriores, xˉ=(4,28+9,16+11,73)÷3=25,17÷3=8,39. O desvio do dado novo é zero, e a soma dos quadrados dos desvios não muda: ela vale S=(4,28−8,39)2+(9,16−8,39)2+(11,73−8,39)2=16,89+0,59+11,16≈28,64 com três dados e continua 28,64 com quatro. O que muda é o divisor amostral: de 3−1=2 para 4−1=3. A variância amostral passa de S/2 para S/3, isto é, fica multiplicada por 32; a redução é de 31≈33,3%. Resposta: 33. Conferência: nem foi preciso calcular S; a razão entre as variâncias é a razão entre os divisores, S/2S/3=32, qualquer que seja S. Se alguém usasse a variância populacional, os divisores seriam 3 e 4, a razão seria 43 e a redução, 25%: o enunciado diz “amostral” justamente para que o divisor seja n−1.
O mecanismo do exemplo é geral e rende item: acrescentar um dado igual à média não altera a média nem a soma dos quadrados dos desvios, e por isso multiplica a variância populacional por n+1n e a amostral por nn−1. Nos dois casos a dispersão diminui, porque o dado novo “puxa” o conjunto para o centro.
A palavra "amostra" no texto não é o mesmo que "amostral" na fórmula
Um enunciado pode descrever uma amostra (“foram sorteadas 20 famílias”) e, ainda assim, pedir “a variância dos dados”, que é a populacional, com divisor n. O que decide é a definição que o item usa, não a palavra do contexto. Se o item diz “variância amostral”, define s2 com n−1 ou avisa “divida por n−1”, use n−1; em qualquer outro caso, n. Em itens de limiar, confira se a escolha do divisor muda o julgamento: nos itens de 2017, 2018 e 2019 do PAS 3 não muda, e no de 2023 muda tudo.
Somar ou multiplicar uma constante: o que acontece com o desvio padrão
A linha Verde passa a parar num ponto a mais, e todas as viagens ficam 4 minutos mais longas: 22, 28, 34, 40 e 46 minutos. A média sobe para 34. E os desvios? 22−34=−12, 28−34=−6, e assim por diante: são exatamente os mesmos −12,−6,0,6,12 de antes. A variância continua 72 e o desvio padrão, 8,5 minutos. Faz sentido: deslocar todos os dados juntos não os aproxima nem os afasta uns dos outros.
Agora suponha que os tempos sejam convertidos para segundos, isto é, multiplicados por 60: 1 080, 1 440, 1 800, 2 160 e 2 520 segundos. A média vai a 1 800 segundos, e os desvios ficam −720,−360,0,360,720: cada um é o desvio antigo vezes 60. Os quadrados ficam multiplicados por 602=3600, a variância passa de 72 para 72×3600=259200 s² e o desvio padrão de 8,49 para 8,49×60≈509 segundos. O desvio padrão foi multiplicado pela constante; a variância, pelo quadrado dela.
Efeito de uma constante
Se a mesma constante c é somada a todos os dados, a média aumenta em c e a variância e o desvio padrão não mudam: σx+c=σx.
Se todos os dados são multiplicados por uma constante k, a média fica multiplicada por k, o desvio padrão fica multiplicado por ∣k∣ e a variância, por k2: σkx=∣k∣σx e σkx2=k2σx2.
As duas regras saem da definição: somar c não altera nenhum desvio (xi+c−(xˉ+c)=xi−xˉ); multiplicar por k multiplica cada desvio por k e cada quadrado por k2. O módulo em ∣k∣ existe porque o desvio padrão nunca é negativo: multiplicar os dados por −2 dobra o desvio padrão.
Exemplo resolvido 4: o reajuste e o abono. Os salários de uma empresa têm média R$ 3 000 e desvio padrão R$ 450. (a) Se todos receberem um abono fixo de R$ 200, a média vai a R$ 3 200 e o desvio padrão continua R$ 450. (b) Se, em vez disso, todos receberem um reajuste de 8%, cada salário é multiplicado por 1,08: a média vai a 3000×1,08=3240 e o desvio padrão a 450×1,08=486 reais; a variância, de 4502=202500 para 202500×1,082=202500×1,1664=236196. Conferência:4862=236196. O reajuste percentual mantém a dispersão relativa (486 está para 3 240 como 450 está para 3 000) e aumenta a dispersão absoluta; o abono faz o contrário. É a diferença entre as duas medidas que a seção do coeficiente de variação explora.
A regra da multiplicação é o que governa a troca de unidade. Um desvio padrão de 0,08 m é um desvio padrão de 8 cm (vezes 100); uma variância de 0,0064 m² é uma variância de 64 cm² (vezes 1002). Uma temperatura em graus Celsius convertida para Fahrenheit (F=1,8C+32) combina as duas regras: o desvio padrão fica multiplicado por 1,8 e o +32 não faz nada. O ENEM gosta desse tema com sacas de café e hectares: um desvio padrão em quilogramas por talhão vira sacas por hectare dividindo-se por 60 (quilogramas por saca) e pela área do talhão em hectares, e a variância, pelo quadrado desse fator.
Uma série em progressão aritmética não tem desvio padrão zero. Em 2008, o PAS 3 apresentou um gráfico da produção mundial de cereais com as barras 1 930 (1995), 2 100 (2000) e 2 270 (2005), que crescem de 170 em 170, e afirmou: “Considerando-se que, no gráfico I, os dados de 1995, 2000 e 2005 estão em progressão aritmética, conclui-se que o desvio-padrão associado a essa série numérica é igual a zero.” O desvio padrão só é zero quando todos os dados são iguais; numa progressão aritmética de razão diferente de zero, os dados são todos diferentes. Média: 2100; desvios: −170,0,+170; quadrados: 28900,0,28900; variância 57800÷3≈19267; σ≈139 milhões de toneladas. Errado. O item confunde a regularidade do crescimento (a razão constante) com a ausência de dispersão. Para três termos em progressão aritmética de razão r, o desvio padrão é r2/3≈0,82r, sempre proporcional à razão.
Comparar regularidade: menor desvio padrão, mais regular
Em muitas situações, a pergunta não é “quanto vale o desvio padrão” e sim “qual dos conjuntos é mais regular”, e a resposta é imediata: o de menor desvio padrão. Duas jogadoras de basquete marcaram, em cinco jogos, 18, 20, 22, 19 e 21 pontos (Ana) e 10, 30, 25, 12 e 23 pontos (Bia). As duas somaram 100 pontos, média 20. Ana: desvios −2,0,2,−1,1, quadrados 4,0,4,1,1, variância 10÷5=2, σ≈1,4 ponto. Bia: desvios −10,10,5,−8,3 (soma zero), quadrados 100,100,25,64,9, variância 298÷5=59,6, σ≈7,7 pontos. A técnica que precisa de 20 pontos garantidos num jogo decisivo escala Ana; a que precisa de uma chance de 30 escala Bia. Mesma média, perfis opostos, e é o desvio padrão que descreve o perfil.
Controle de qualidade: a máquina que enche pacotes
Uma máquina enche pacotes de arroz de 1 kg. Nenhuma máquina acerta 1 000 g em todos os pacotes; o que o fabricante controla é a média (próxima de 1 000 g, para não lesar o cliente nem a empresa) e o desvio padrão (pequeno, para que quase nenhum pacote saia fora da tolerância). Duas máquinas com média 1 000 g e desvios padrão 2 g e 8 g são máquinas muito diferentes: com tolerância de ±5 g, a primeira quase nunca produz um pacote reprovado, e a segunda produz muitos. Em laboratórios, fábricas e hospitais, “o processo está sob controle” significa que a média está no alvo e o desvio padrão está abaixo de um limite; um aumento do desvio padrão, mesmo com a média certa, é sinal de que algo (uma peça gasta, um lote de matéria-prima) mudou.
O ENEM transforma a regularidade em item dando a tabela pronta, com média, mediana e desvio padrão de vários atletas, candidatos ou equipes, e perguntando qual é “o mais regular”: basta ler a coluna do desvio padrão e escolher o menor, sem fazer conta. O PAS prefere pedir a conta. Em 2017, com um gráfico da produção de etanol no Brasil, nos Estados Unidos e no mundo, de 2006 a 2015, em bilhões de litros, a prova apresentou um item de múltipla escolha: “A série numérica correspondente à produção brasileira de etanol de 2008 a 2011, na unidade bilhões de litros ao quadrado, tem variância com valor: A) inferior a 3,5; B) superior a 3,5 e inferior a 3,7; C) superior a 3,7 e inferior a 3,9; D) superior a 3,9.” As barras do Brasil nesses anos eram 27,6; 25,7; 27,6 e 22,7. Média: 103,6÷4=25,9. Desvios: 1,7; −0,2; 1,7; −3,2 (soma 3,4−3,4=0). Quadrados: 2,89; 0,04; 2,89; 10,24; soma 16,06. Variância: 16,06÷4=4,015, superior a 3,9. Opção D. O enunciado avisou a unidade (“bilhões de litros ao quadrado”) para deixar claro que a variância, e não o desvio padrão, era o alvo, e as faixas das opções estão separadas por 0,2: um erro de arredondamento na média (25,9 é exato, mas 26 não) ou um quadrado esquecido troca a faixa.
Coeficiente de variação: dispersão relativa
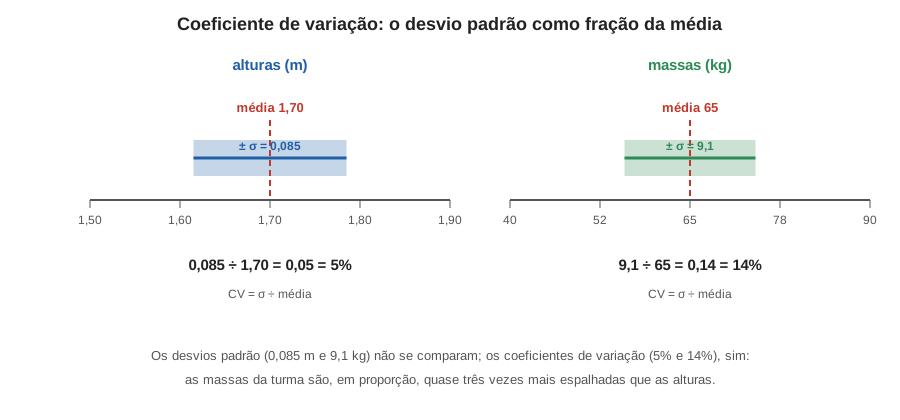
O desvio padrão compara bem conjuntos medidos na mesma unidade e na mesma escala. Quando as unidades ou as escalas são diferentes, ele engana. As alturas de uma turma têm média 1,70 m e desvio padrão 0,085 m; as massas, média 65 kg e desvio padrão 9,1 kg. Dizer que “as massas variam mais, porque 9,1 é maior que 0,085” não faz sentido: são quilogramas contra metros. E mesmo na mesma unidade a escala atrapalha: um desvio padrão de 500 kg nas massas de um grupo de elefantes (média 5 000 kg) é muito menos, em proporção, do que um desvio padrão de 0,8 kg nas massas de um grupo de gatos (média 4 kg).
Coeficiente de variação
O coeficiente de variação é o desvio padrão dividido pela média, em geral expresso em porcentagem:
CV=xˉσ(×100%).
É um número sem unidade (a unidade do desvio padrão cancela a da média), e por isso compara a dispersão de conjuntos medidos em unidades ou escalas diferentes. Lê-se “o desvio padrão é tantos por cento da média”. Quanto menor o CV, mais homogêneo o conjunto em relação ao seu próprio tamanho.
Os desvios padrão das alturas (0,085 m) e das massas (9,1 kg) não se comparam diretamente. Divididos pelas respectivas médias, viram 5% e 14%: as massas da turma são, em proporção, quase três vezes mais espalhadas que as alturas. Diagrama autoral.
Exemplo resolvido 5: alturas, massas, elefantes e gatos. Alturas: CV=0,085÷1,70=0,05=5%. Massas: CV=9,1÷65=0,14=14%. As massas são relativamente mais dispersas, o que combina com a experiência: numa turma, as alturas variam uns centímetros em torno de 1,70 m, e as massas variam dezenas de quilogramas. Elefantes: 500÷5000=10%. Gatos: 0,8÷4=20%. Os gatos são, em proporção, duas vezes mais heterogêneos que os elefantes, embora o desvio padrão dos elefantes seja seiscentas vezes maior. Conferência: o CV não muda com a unidade (massas em gramas: 9100÷65000=0,14), o que é o teste de que a medida é relativa.
O ENEM usou o coeficiente de variação num item sobre a troca de ração de coelhos: a ração atual dá média 10 kg e desvio padrão 1 kg (CV=10%); a nova dá desvio padrão 1,5 kg, e será adotada se o seu CV for menor; para 1,5÷xˉ<0,1 é preciso xˉ>15 kg. O molde é o que se espera na 2.ª etapa: dois pares (média, desvio padrão) e a pergunta “qual varia mais”, ou um par incompleto e um limiar para a média.
O coeficiente de variação tem limites. Ele exige média positiva e uma escala com zero significativo: funciona para massas, tempos, preços e contagens, em que “zero” é ausência; não funciona para temperaturas em graus Celsius, porque o zero do Celsius é convencional (os mesmos dados em Kelvin dão outro CV, sem que a dispersão tenha mudado), nem para conjuntos de média próxima de zero, em que a divisão explode. Nos itens de prova, os dados são sempre do primeiro tipo.
Dados agrupados: a variância numa tabela de frequências
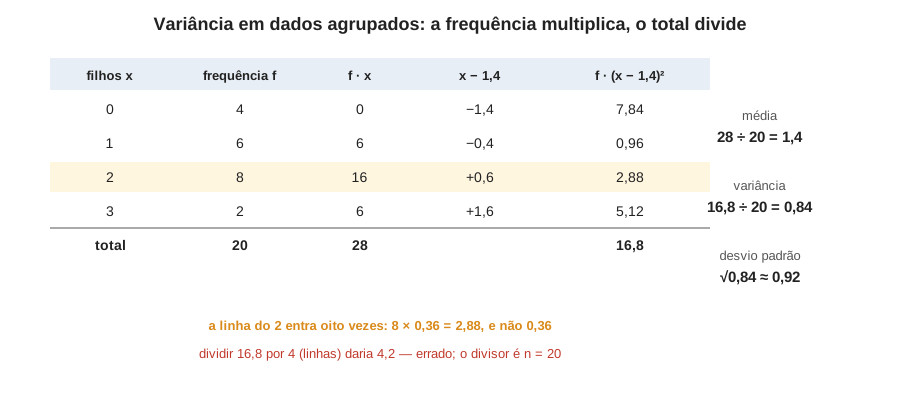
Em vinte famílias de um prédio, o número de filhos foi registrado assim: 4 famílias sem filhos, 6 com um filho, 8 com dois e 2 com três. A lista tem vinte números (quatro zeros, seis uns, …), e a tabela já diz quantas vezes cada valor entra na conta: a frequência é um peso, tanto na média quanto na variância.
Variância em dados agrupados
Numa tabela de frequências com valores xi e frequências fi, com n=∑fi observações:
xˉ=n∑fixi,σ2=n∑fi(xi−xˉ)2.
Cada quadrado de desvio entra multiplicado pela frequência do seu valor, e o divisor é o total de observações, não o número de linhas da tabela.
A variância de uma tabela de frequências: cada quadrado de desvio entra multiplicado pela frequência da linha, e a soma (16,8) é dividida pelo total de observações (20), não pelas quatro linhas. Diagrama autoral.
Exemplo resolvido 6: os filhos das vinte famílias. Média: 204×0+6×1+8×2+2×3=200+6+16+6=2028=1,4 filho por família. Desvios por linha: −1,4; −0,4; +0,6; +1,6. Quadrados: 1,96; 0,16; 0,36; 2,56. Multiplicados pelas frequências: 4×1,96=7,84; 6×0,16=0,96; 8×0,36=2,88; 2×2,56=5,12; soma 16,8. Variância: 16,8÷20=0,84; desvio padrão 0,84≈0,92 filho. Conferência: a soma dos desvios ponderados pelas frequências é 4(−1,4)+6(−0,4)+8(0,6)+2(1,6)=−5,6−2,4+4,8+3,2=0. Quem divide 16,8 por 4 (as linhas) encontra 4,2 e erra; quem calcula a variância dos quatro valores 0, 1, 2 e 3 como se fossem os dados (média 1,5, variância 1,25) também erra, porque ignora que o 2 apareceu oito vezes e o 3, duas.
A tabela de frequências é a forma em que a dispersão aparece quando os dados são muitos: notas de uma turma agrupadas por valor, número de acertos por candidato, gols por partida. A conta é a de sempre, com a frequência multiplicando cada parcela.
Ler a dispersão num gráfico: barras, linhas e histogramas
Os itens reais de variância e desvio padrão quase nunca dão a lista de dados em prosa; dão um gráfico de barras ou de linhas, e a primeira tarefa é ler os valores certos. Em 2013, o gráfico da frota de veículos por 100 habitantes trazia treze barras, de 2000 a 2012 (17,6; 18,5; 19,6; 20,7; 21,6; 22,8; 24,3; 26,2; 28,5; 30,9; 33,9; 36,5 e 39,5), e o item de resposta numérica pediu: “Determine a variância dos dados referentes ao período de 2000 a 2003. Multiplique o resultado por 100.” Só quatro barras entram: 17,6; 18,5; 19,6 e 20,7. Média: 76,4÷4=19,1. Desvios: −1,5; −0,6; +0,5; +1,6 (soma zero). Quadrados: 2,25; 0,36; 0,25; 2,56; soma 5,42. Variância: 5,42÷4=1,355; vezes 100, 135,5; desprezada a parte fracionária, 135. O fator de escala existe para a resposta caber nos três algarismos do caderno de respostas e se aplica por último. Quem usa o divisor n−1 encontra 5,42÷3≈1,807 e marca 180, errado: o gabarito oficial, 135, confirma que “variância” sem adjetivo é a populacional.
Em 2019, o gráfico de barras horizontais da participação feminina na ciência trazia, para 14 países ibero-americanos, dois percentuais: o total e o do decil mais produtivo. O item escolheu seis países: “O desvio padrão da série relativa ao decil mais produtivo, quando considerados os países Argentina, Brasil, Chile, Equador, Peru e Uruguai, é superior a 6%.” Os valores do decil nesses países: 43, 40, 26, 28, 30 e 36. Soma 203, média 203÷6≈33,83. A média é um decimal periódico, e aqui a fórmula alternativa poupa trabalho: ∑x2=432+402+262+282+302+362=1849+1600+676+784+900+1296=7105; dividido por 6, 1184,17; menos xˉ2=33,832≈1144,69, dá σ2≈39,5. O limiar ao quadrado é 36, e 39,5>36: σ>6. Certo (σ≈6,3 pontos percentuais). Dois cuidados de leitura: pegar a barra certa de cada país (o decil, em cinza, e não o total, em preto) e só os seis países listados.
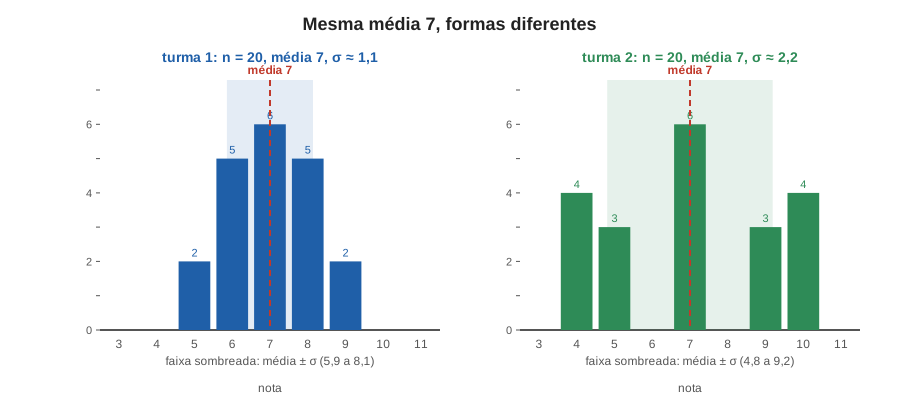
A leitura qualitativa também é cobrada: dois histogramas com a mesma média podem ter formas muito diferentes, e a forma diz qual tem o maior desvio padrão.
Duas turmas de 20 estudantes com média 7. Na turma 1 as barras se apertam em torno da média (desvio padrão 1,1); na turma 2 elas se afastam para os dois lados (desvio padrão 2,2). Quanto mais massa de barras longe do centro, maior o desvio padrão, mesmo sem nenhuma conta. Diagrama autoral.
Nas duas turmas da figura, as frequências são, na turma 1, nota 5: 2; 6: 5; 7: 6; 8: 5; 9: 2 e, na turma 2, nota 4: 4; 5: 3; 7: 6; 9: 3; 10: 4. As duas têm 20 estudantes e soma 140, média 7. Pela fórmula de dados agrupados, a turma 1 tem ∑f(x−7)2=2×4+5×1+6×0+5×1+2×4=26, variância 1,3 e σ≈1,1; a turma 2 tem 4×9+3×4+0+3×4+4×9=96, variância 4,8 e σ≈2,2. A conta confirma o olho: barras altas longe da média (os quatro 4 e os quatro 10 da turma 2) são o que mais pesa na variância, porque entram ao quadrado.
Quantos dados cabem entre xˉ−σ e xˉ+σ? Em 2022, com um gráfico de barras das populações das oito maiores etnias indígenas do Brasil segundo o Censo de 2010 (Tikuna 46, Guarani Kaiowá 44, Kaingang 38, Makuxi 29, Terena 29, Tenetehara 24, Yanomami 22 e Potiguara 20, em milhares), o PAS 3 afirmou: “Tomando-se m como a média e s como o desvio-padrão das etnias indígenas apresentadas, é correto afirmar que todas as populações apresentadas estão no intervalo [m−s,m+s].” Soma 252, média m=31,5. Desvios: 14,5; 12,5; 6,5; −2,5; −2,5; −7,5; −9,5; −11,5 (soma 33,5−33,5=0). Quadrados: 210,25; 156,25; 42,25; 6,25; 6,25; 56,25; 90,25; 132,25; soma 700. Variância 700÷8=87,5; s≈9,35. O intervalo [m−s,m+s] vai de cerca de 22,2 a 40,8 mil: ficam fora os dois maiores (46 e 44) e os dois menores (22 e 20). Errado. Repare que o julgamento não depende do divisor: com n−1, s=100=10 exatamente, o intervalo é [21,5;41,5] e três populações continuam fora. O item ensina uma leitura do desvio padrão que vale guardar: o intervalo de um desvio padrão em torno da média contém a parte central dos dados (aqui, quatro das oito populações), nunca todos eles, a menos que sejam todos iguais.
A regra 68–95–99,7
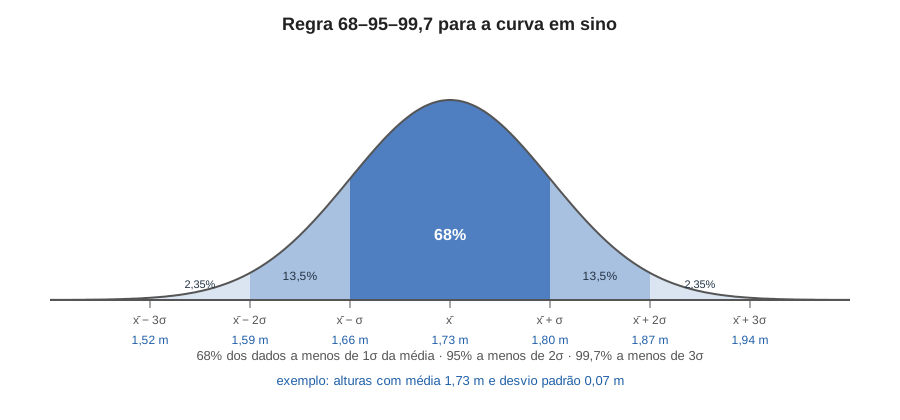
Para dados com a forma de um sino (a chamada distribuição normal: alturas de adultos, erros de medida, notas de provas grandes), o desvio padrão ganha uma leitura numérica fixa: cerca de 68% dos dados ficam entre xˉ−σ e xˉ+σ, cerca de 95% entre xˉ−2σ e xˉ+2σ e cerca de 99,7% entre xˉ−3σ e xˉ+3σ. Se as alturas dos homens adultos de um país têm média 1,73 m e desvio padrão 0,07 m, cerca de dois terços deles medem entre 1,66 m e 1,80 m, e só um em trezentos mede mais de 1,94 m ou menos de 1,52 m. A regra é uma propriedade da curva normal, não de qualquer conjunto de dados (nas etnias do item de 2022, só 50% ficaram no intervalo de um desvio padrão), e a prova do ensino médio a cobra, quando cobra, como leitura de gráfico: dado o sino com a média e o desvio padrão marcados, que fração fica em cada faixa.
Numa distribuição em forma de sino, o desvio padrão mede as faixas: 68% dos dados a menos de um desvio padrão da média, 95% a menos de dois, 99,7% a menos de três. O exemplo das alturas (média 1,73 m, desvio padrão 0,07 m) traduz as marcas em metros. Diagrama autoral.
Dispersão em contexto: notas, salários e o que o desvio padrão garante
Um desvio padrão pequeno diz mais do que parece: ele limita o tamanho de qualquer desvio. Como a variância é a média dos quadrados dos desvios, a soma dos quadrados é nσ2, e nenhum quadrado isolado pode ultrapassar essa soma. Logo, nenhum dado pode estar a mais de σn da média. O ENEM de 2024 usou esse raciocínio: cinco grupos de 11 mulheres, com um quadro incompleto de idades (mínimo, máximo, média, mediana, moda e desvio padrão), e a pergunta de qual grupo certamente tinha a maioria entre 20 e 30 anos; no grupo com média 25 e desvio padrão 1, a soma dos quadrados dos desvios é 11×12=11, e uma única idade fora de [20,30] teria desvio maior que 5 e quadrado maior que 25, impossível. Com média 25 e desvio padrão 1, todas as 11 idades estão entre 20 e 30. É o mesmo argumento com que uma coordenação lê o boletim: uma turma de 10 estudantes com média 7 e desvio padrão 0,5 tem soma dos quadrados 10×0,25=2,5, e uma nota 4 (desvio 3, quadrado 9) é impossível; ninguém nessa turma está em recuperação.
A dispersão também fecha a história da média contra a mediana. Numa oficina com nove salários de R$ 2 000 e um de R$ 20 000, a média é R$ 3 800 e a mediana, R$ 2 000; o desvio padrão conta o resto. Desvios: −1800 (nove vezes) e +16200. Quadrados: 3240000×9=29160000 e 262440000; soma 291600000; variância 29160000; σ=5400 reais, maior que a média e quase três vezes o salário de nove das dez pessoas. Um desvio padrão desse tamanho avisa que a média não descreve ninguém: o conjunto tem um valor extremo que domina tudo, e a mediana é o resumo honesto. Quando a prova pergunta qual medida descreve “o salário típico” em situações assim, a resposta é a mediana; o desvio padrão e a amplitude aparecem como distratores que medem outra coisa, o espalhamento, e não o centro.
Desvio padrão negativo, variância na unidade errada e raiz esquecida
Três erros de fim de conta derrubam itens com a conta certa. Desvio padrão negativo não existe: se apareceu, houve erro de sinal num quadrado ou na raiz. Unidade: a variância está na unidade ao quadrado (min², kg², “bilhões de litros ao quadrado”, como o item de 2017 escreveu); o desvio padrão, na unidade dos dados. Raiz esquecida: quando o item pede o desvio padrão e compara com um limiar, ou se extrai a raiz da variância, ou se compara a variância com o limiar ao quadrado; comparar a variância com o limiar sem elevar ao quadrado é o erro mais comum do assunto (0,315 “é inferior a 0,70” por sorte; 39,5 “é superior a 6” também, mas por um motivo errado, e na próxima prova o limiar não perdoa).
Como a banca pergunta
Na 2.ª etapa, a dispersão está na matriz desde dezembro de 2022, herdada da 3.ª, e ainda não rendeu item: a estreia é provável, e o molde vem da 3.ª etapa, que tem sete itens em quinze anos. Eles cabem em cinco formatos.
Variância em resposta numérica, com fator de escala (tipo B): a variância de quatro barras de um gráfico, vezes 100, desprezada a parte fracionária (2013/72, resposta 135). O trabalho é escolher as barras certas, fazer a tabela dado–desvio–quadrado e aplicar o fator por último.
Desvio padrão contra um limiar (tipo A): “inferior a 0,70” com quatro barras (2018/119, certo); “superior a 6%” com seis barras escolhidas entre catorze (2019/120, certo). Compare a variância com o quadrado do limiar; não extraia a raiz.
Variância em faixas (tipo C): quatro opções com faixas de 0,2 de largura (2017/117, “superior a 3,9”, opção D). A média exata importa; arredondar antes do fim troca a faixa.
Variância amostral e o efeito de um dado novo (tipo B): a redução percentual da variância amostral quando se acrescenta um dado igual à média (2023/92, resposta 33). O divisor é n−1 porque o enunciado disse “amostral”; a razão entre as variâncias é a razão entre os divisores.
Conceito (tipo A): o desvio padrão de uma progressão aritmética “é igual a zero” (2008/18, errado); “todas as populações estão em [m−s,m+s]” (2022/74, errado). Aqui a conta é curta e a ideia é tudo: só dados iguais têm desvio padrão zero; o intervalo de um desvio padrão contém a parte central dos dados, não todos.
Três avisos de formato. Primeiro, os dados vêm de gráfico, e o item recorta uma parte dele (“de 2000 a 2003”, “de 2008 a 2011”, “Argentina, Brasil, Chile, Equador, Peru e Uruguai”, “o decil mais produtivo”): leia o recorte antes de somar. Segundo, a banca costuma dar a média pronta em um item vizinho (“sabendo que a média é 26,2”) para outro uso; a média do recorte é outra, e tem de ser calculada. Terceiro, nos itens de limiar, confira se a escolha entre n e n−1 muda o julgamento; quando não muda, não perca tempo com a dúvida; quando muda, a palavra “amostral” decide.
Os erros que mais derrubam
Dividir pela quantidade errada. Pelo número de dados (n), não pela soma dos dados nem pelo número de linhas da tabela; n−1 só quando o item diz “amostral”.
Esquecer de elevar ao quadrado e somar desvios com sinal: a soma dá zero, e zero não é dispersão.
Comparar a variância com o limiar do desvio padrão sem elevar o limiar ao quadrado (ou sem extrair a raiz).
Desvio padrão negativo ou variância com unidade simples: sinal de conta errada.
Somar uma constante e achar que o desvio padrão muda. Ele não muda; só a média se desloca. Multiplicar por k multiplica o desvio padrão por ∣k∣ e a variância por k2.
Trocar de unidade sem elevar o fator ao quadrado na variância: metros para centímetros multiplica a variância por 10 000.
Comparar desvios padrão de escalas diferentes e concluir que “o maior varia mais”: use o coeficiente de variação.
Ler a amplitude como dispersão total: ela usa dois dados e ignora o resto.
Confundir regularidade de crescimento com ausência de dispersão: uma progressão aritmética tem desvio padrão proporcional à razão, nunca zero.
Achar que todos os dados cabem em [xˉ−σ,xˉ+σ]: o intervalo contém a parte central (68% numa curva normal; menos ou mais em outras formas), e os extremos ficam fora.
Aplicar o fator de escala cedo ou desprezar a parte fracionária antes do fim.
Tratar as linhas de uma tabela de frequências como dados: a frequência multiplica cada quadrado de desvio e o divisor é ∑fi.
O essencial em meia página
Amplitude:xmax−xmin; usa dois dados; sensível a um extremo.
Desvio:xi−xˉ; a soma dos desvios é sempre zero (conferência obrigatória).
Variância:σ2=n∑(xi−xˉ)2=n∑xi2−xˉ2; unidade ao quadrado; zero só se todos os dados são iguais.
Desvio padrão:σ=σ2; unidade dos dados; “distância típica” até a média; nunca negativo. Limiar: compare σ2 com o quadrado do limiar.
Amostral:s2=n−1∑(xi−xˉ)2, só quando o enunciado diz “amostral”; sempre um pouco maior que σ2. Dado novo igual à média: σ2 fica vezes n+1n; s2, vezes nn−1.
Constantes: somar c não muda σ; multiplicar por k multiplica σ por ∣k∣ e σ2 por k2 (troca de unidade, reajuste percentual).
Regularidade: menor σ, mais regular (mesma unidade e escala).
Coeficiente de variação:CV=σ/xˉ, sem unidade, para comparar escalas e unidades diferentes; exige média positiva e zero significativo.
Dados agrupados:σ2=∑fi∑fi(xi−xˉ)2; a frequência multiplica, o total divide.
Leitura de gráfico: recorte as barras pedidas, monte a tabela dado–desvio–quadrado; histogramas com barras altas longe do centro têm σ maior; [xˉ−σ,xˉ+σ] contém a parte central (68% no sino), não tudo.
Garantia:∑(xi−xˉ)2=nσ2; nenhum dado se afasta da média mais que σn.
Na prova: média do recorte, desvios somando zero, quadrados, divisão por n, fator de escala por último; “amostral” é a única senha para n−1.
Exercícios temporariamente indisponíveis
Não foi possível consultar o banco de questões. O conteúdo da aula continua disponível.
Flashcards temporariamente indisponíveis
Não foi possível consultar os cartões de revisão.
Amplitude e Distância Interquartil
Portal da Matemática OBMEP · 11:33
Introdução. O professor Maurício Carvalho (Portal da Matemática, IMPA/OBMEP, 1.º ano) mostra “3 amostras bem diferentes com exatamente a mesma moda, mediana e média” e conclui que as medidas de posição não bastam, apresentando a amplitude como primeira medida de dispersão: é a abertura desta página (“Mesma média, histórias diferentes”) e a seção da amplitude.
Variância e Desvio Padrão
Portal da Matemática OBMEP · 9:34
Aprofundamento. Na mesma série, a aula apresenta “as medidas de dispersão mais utilizadas na estatística: variância e desvio padrão”, com a definição pelos quadrados dos desvios e a raiz que devolve a unidade dos dados: são as seções “Variância: a média dos quadrados dos desvios” e “Desvio padrão: de volta à unidade dos dados”.
Desvio padrão amostral e vício
Khan Academy Brasil · 9:04
Aprofundamento. Vídeo dublado em português do Brasil que calcula o desvio padrão amostral a partir de um exemplo e justifica por que o divisor n − 1 aparece quando se estima a dispersão de uma população a partir de uma amostra: é a seção “Populacional ou amostral: quando dividir por n − 1”, a única senha para n − 1 nos itens do PAS.
Exercícios
Portal da Matemática OBMEP · 8:02
Aplicação. “Mais exercícios para fixar os conceitos adquiridos”: o professor resolve exercícios do bloco de medidas de dispersão do Portal da OBMEP, no roteiro média, desvios, quadrados, variância e raiz que os exemplos resolvidos desta página seguem.
Questão ENEM PPL 2019 — estatística descritiva — desvio padrão
Ed Academy · 5:02
Resolução. Resolve a questão do ENEM PPL 2019 do motorista novato (tempos 48, 54, 50, 46, 44, 52 e 49 minutos e uma tabela que classifica a variabilidade pelo desvio padrão), que está nos exercícios desta página: a conta completa da variância e do desvio padrão com sete dados e a leitura do resultado numa faixa, como nos itens de limiar da seção “Como a banca pergunta”.
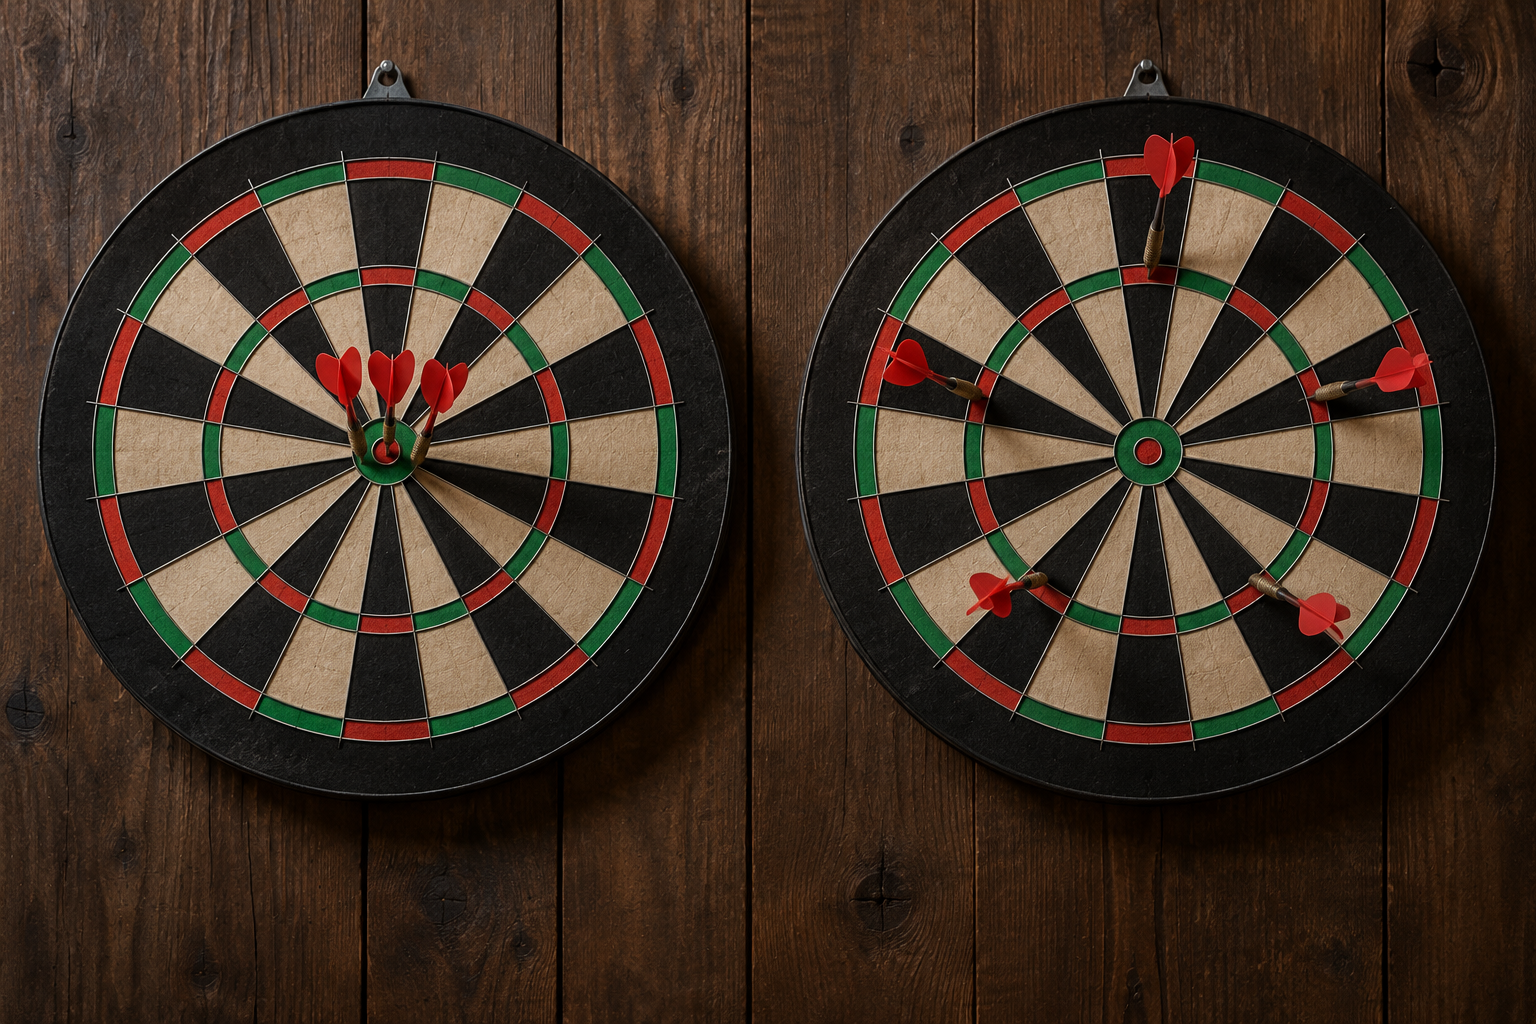
Os dois jogadores acertaram, em média, o centro. Só a dispersão separa quem é regular de quem não é: é isso que o desvio padrão mede.As duas linhas têm média 30 minutos e mediana 30 minutos, e nada mais em comum: a Azul concentra os tempos a um ou dois minutos do centro, a Verde os espalha até doze minutos para cada lado. O desvio padrão (1,1 contra 8,5 minutos) é o número que separa as duas. Diagrama autoral.Os desvios da linha Verde em relação à média 30. Os negativos (à esquerda) e os positivos (à direita) se cancelam na soma, que dá zero em qualquer conjunto de dados; elevados ao quadrado, todos ficam positivos e os maiores pesam mais. A média dos quadrados, 360÷5=72, é a variância. Diagrama autoral.As quatro barras do item do PAS 3 de 2018 (mulheres eleitas vereadoras, em milhares) e a linha da média, 7,1. Os desvios somam zero; os quadrados somam 1,26; a variância é 0,315. Como 0,315<0,702=0,49, o desvio padrão é inferior a 0,70 sem que seja preciso extrair a raiz. Diagrama autoral com os dados do gráfico do TSE impresso na prova.Os desvios padrão das alturas (0,085 m) e das massas (9,1 kg) não se comparam diretamente. Divididos pelas respectivas médias, viram 5% e 14%: as massas da turma são, em proporção, quase três vezes mais espalhadas que as alturas. Diagrama autoral.A variância de uma tabela de frequências: cada quadrado de desvio entra multiplicado pela frequência da linha, e a soma (16,8) é dividida pelo total de observações (20), não pelas quatro linhas. Diagrama autoral.Duas turmas de 20 estudantes com média 7. Na turma 1 as barras se apertam em torno da média (desvio padrão 1,1); na turma 2 elas se afastam para os dois lados (desvio padrão 2,2). Quanto mais massa de barras longe do centro, maior o desvio padrão, mesmo sem nenhuma conta. Diagrama autoral.Numa distribuição em forma de sino, o desvio padrão mede as faixas: 68% dos dados a menos de um desvio padrão da média, 95% a menos de dois, 99,7% a menos de três. O exemplo das alturas (média 1,73 m, desvio padrão 0,07 m) traduz as marcas em metros. Diagrama autoral.Duas linhas com a mesma média de 30 minutos: numa a viagem dura sempre uns 30 minutos; na outra, pode durar 18 ou 42. Quem tem hora marcada precisa do desvio padrão, não só da média.Cinco pesagens da mesma amostra nunca dão o mesmo número. A variância das medidas diz quanto o instrumento oscila, e a versão amostral, com divisor n − 1, é a que estima a oscilação de todas as pesagens que não foram feitas.Quatro eleições, quatro números de vereadoras eleitas: 6,6; 6,5; 7,5 e 7,8 mil. A prova perguntou se o desvio padrão ficava abaixo de 0,70, e a resposta sai sem raiz quadrada: basta comparar a variância com o quadrado do limiar.As alturas de uma turma variam poucos centímetros em torno de 1,70 m; as massas variam dezenas de quilos. Para comparar as duas dispersões, o desvio padrão não serve: é o coeficiente de variação, 5% contra 14%.Duas jogadoras com a mesma média de 20 pontos por jogo: uma marca sempre entre 18 e 22, a outra oscila entre 10 e 30. A técnica escolhe pelo desvio padrão, conforme precise de garantia ou de uma chance de explosão.Duas turmas com média 7: numa, as notas se apertam em torno do 7; na outra, vão de 4 a 10. O histograma mostra o que a média esconde, e o desvio padrão põe número nisso.Nenhuma máquina enche todos os pacotes com exatamente 1 000 g. O que a fábrica controla é a média, perto do alvo, e o desvio padrão, pequeno o bastante para que quase nenhum pacote saia da tolerância.
Rota PAS 2
Contagem, probabilidade e estatística: decidir sob incerteza · PAS 2
Fontes desta página
Os materiais abaixo contribuíram para a explicação e os exemplos deste assunto.
Rota PAS 2 — Contagem, probabilidade e estatística: decidir sob incerteza · Dispersão: o quanto os dados fogem do centro (conceito: amplitude, variância, desvio padrão, coeficiente de variação; Na prova; armadilha; checagem); O que cai daqui e Radar (dispersão sem item na 2.ª etapa; matriz desde dez/2022); Resolvidos no formato da prova (variância e desvio padrão, tipo B); Exercícios 13, 15 e 16; Banco de treino T15, T16 e T18; Síntese (dispersão)
Recorte por assunto: só as medidas de dispersão. As medidas de centro e a leitura crítica de tabelas ficam na página anterior; probabilidade e contagem têm páginas próprias. O capítulo foi usado como fonte de fatos, de recorte e de itens reais; abertura, exemplos, números e ordem desta página são próprios (linhas de ônibus, jogadoras, filhos por família, turmas de 20, alturas e massas).
Mapa de itens do bloco contagem / probabilidade / estatística do PAS 2 · Itens marcados VD: PAS 3 2008/18, 2013/72, 2017/117, 2018/119, 2019/120, 2022/74 e 2023/92 (variância amostral). PAS 2 2019/110 (modelos gaussianos, tipo C) ficou fora: a página só menciona a curva em sino na regra 68–95–99,7
Mapa vinculante; os sete itens foram abertos na imagem do caderno (200 dpi) e as contas refeitas contra os gabaritos oficiais definitivos. O mapa dizia que o item 2013/72 multiplica a variância por 10; o caderno pede por 100 (gabarito 135).
Cadernos e gabaritos oficiais do PAS/UnB (Cespe/Cebraspe), 3.ª etapa · PAS 3: 2008 (item 18), 2013 (item 72), 2017 (item 117, texto extraído cifrado, lido na imagem), 2018 (item 119), 2019 (item 120), 2022 (item 74), 2023 (item 92)
Itens reproduzidos verbatim; gabaritos conferidos nas classificações (classificacao-pas3/AAAA.json). Os gráficos impressos (cereais 2008, frota 2013, etanol 2017, TSE 2018, OEI 2019, etnias e desmatamento 2022, imigração 2023) foram descritos em texto neutro, com todos os valores, no campo de apoio de cada questão.
Cadernos em PDF (figuras e textos-base dos itens) · 2008-PAS3 p. 4 (gráfico I da produção de cereais); 2013-PAS3 p. 10 (gráfico da frota de veículos por 100 habitantes); 2017-PAS3 p. 18 (gráfico da produção de etanol, Brasil, EUA e mundo, 2006–2015); 2018-PAS3 p. 16 (gráficos do TSE, candidatos e eleitos por sexo); 2019-PAS3 p. 15 (gráfico da OEI, total e decil mais produtivo por país); 2022-PAS3 p. 11 (figuras I e II, etnias indígenas e desmatamento); 2023-PAS3 p. 11 (gráficos I e II, imigração mexicana e balança comercial)
Numeração impressa no rodapé do caderno (nos PDFs de 2008 a 2019 a página do arquivo é uma adiante). Páginas rasterizadas a 200 dpi pelo escritor; todos os valores impressos (barras, rótulos, séries) foram lidos na imagem e transcritos nas questões.