Uma vacina de RNA faz as células de uma pessoa fabricarem uma proteína de vírus sem alterar uma letra do seu DNA, e uma única base trocada no gene da hemoglobina basta para deformar as hemácias. Como quatro letras escritas numa molécula viram vinte tipos de aminoácidos em outra, e por que a informação só corre nesse sentido?
O que você vai aprender
Descrever o nucleotídeo (fosfato, pentose e base), distinguir purinas de pirimidinas e explicar a polaridade 5'→3' de uma fita de ácido nucleico.
Comparar DNA e RNA em açúcar, bases, número de fitas, localização e função, e reconhecer itens que troquem timina por uracila ou fita dupla por simples.
Explicar o pareamento A–T e G–C, o antiparalelismo e a regra de Chargaff, e calcular as porcentagens das quatro bases a partir de uma, o número de pares de bases a partir do comprimento (0,34 nm por par) e o comprimento do DNA de uma célula.
Descrever a replicação semiconservativa, o experimento de Meselson e Stahl e as funções de helicase, primase, DNA-polimerase e ligase, e calcular quantas moléculas existem após n rodadas e quantas conservam uma fita original.
Enunciar o dogma central na formulação de Crick, classificar a transcrição reversa e a replicação de RNA dos vírus como transferências entre ácidos nucleicos e justificar por que a sequência de uma proteína não determina a do gene.
Transcrever uma fita molde em RNA mensageiro, identificar a fita codificadora e descrever o processamento do pré-RNAm em eucariontes (cap, cauda poli-A, splicing e splicing alternativo).
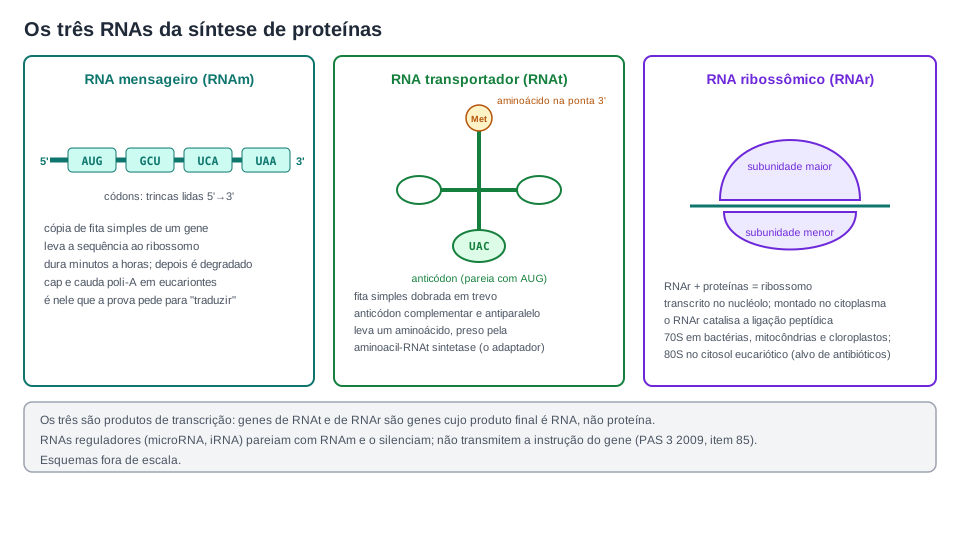
Diferenciar as funções do RNA mensageiro, do RNA transportador (anticódon e aminoácido) e do RNA ribossômico, e escrever o anticódon complementar e antiparalelo a um códon.
Ler a tabela do código genético, localizar AUG e os três códons de parada, traduzir uma sequência e aplicar as propriedades do código (degenerado, não ambíguo, quase universal, sem sobreposição), com a conta n/3 − 1 para o número de aminoácidos.
Narrar a tradução (iniciação, alongamento pelos sítios A, P e E, terminação), explicar o polissomo e a diferença entre ribossomos livres e aderidos ao retículo e entre ribossomos 70S e 80S.
Seguir o caso da anemia falciforme do códon GAG ao GTG e do ácido glutâmico à valina, relacionando a troca de aminoácido à forma da hemoglobina S e às bandas da eletroforese.
Explicar que todas as células de um organismo têm o mesmo genoma e expressam genes diferentes, usando o operon lac e a metilação como exemplos, e distinguir regulação de mutação.
Situar o genoma humano em números (cerca de 3,1 bilhões de pares de bases, cerca de 20 mil genes codificadores em 1 a 2 % do total, Projeto Genoma Humano e sequência completa de 2022) e corrigir as ideias de DNA lixo e de 100 mil genes.
Uma pessoa recebe no braço uma vacina de RNA mensageiro. Dentro de algumas células do músculo, ribossomos leem esse RNA de três em três letras e montam uma proteína do vírus, a mesma que o vírus usaria para entrar na célula. O sistema imune aprende a reconhecer a proteína. Dias depois, o RNA da vacina já foi degradado, e nenhuma letra do DNA da pessoa mudou. Em 2020, a prova do PAS 3 construiu um bloco inteiro em cima dessa cena, e um dos itens cobrava o boato de que a vacina “alteraria o DNA humano”.
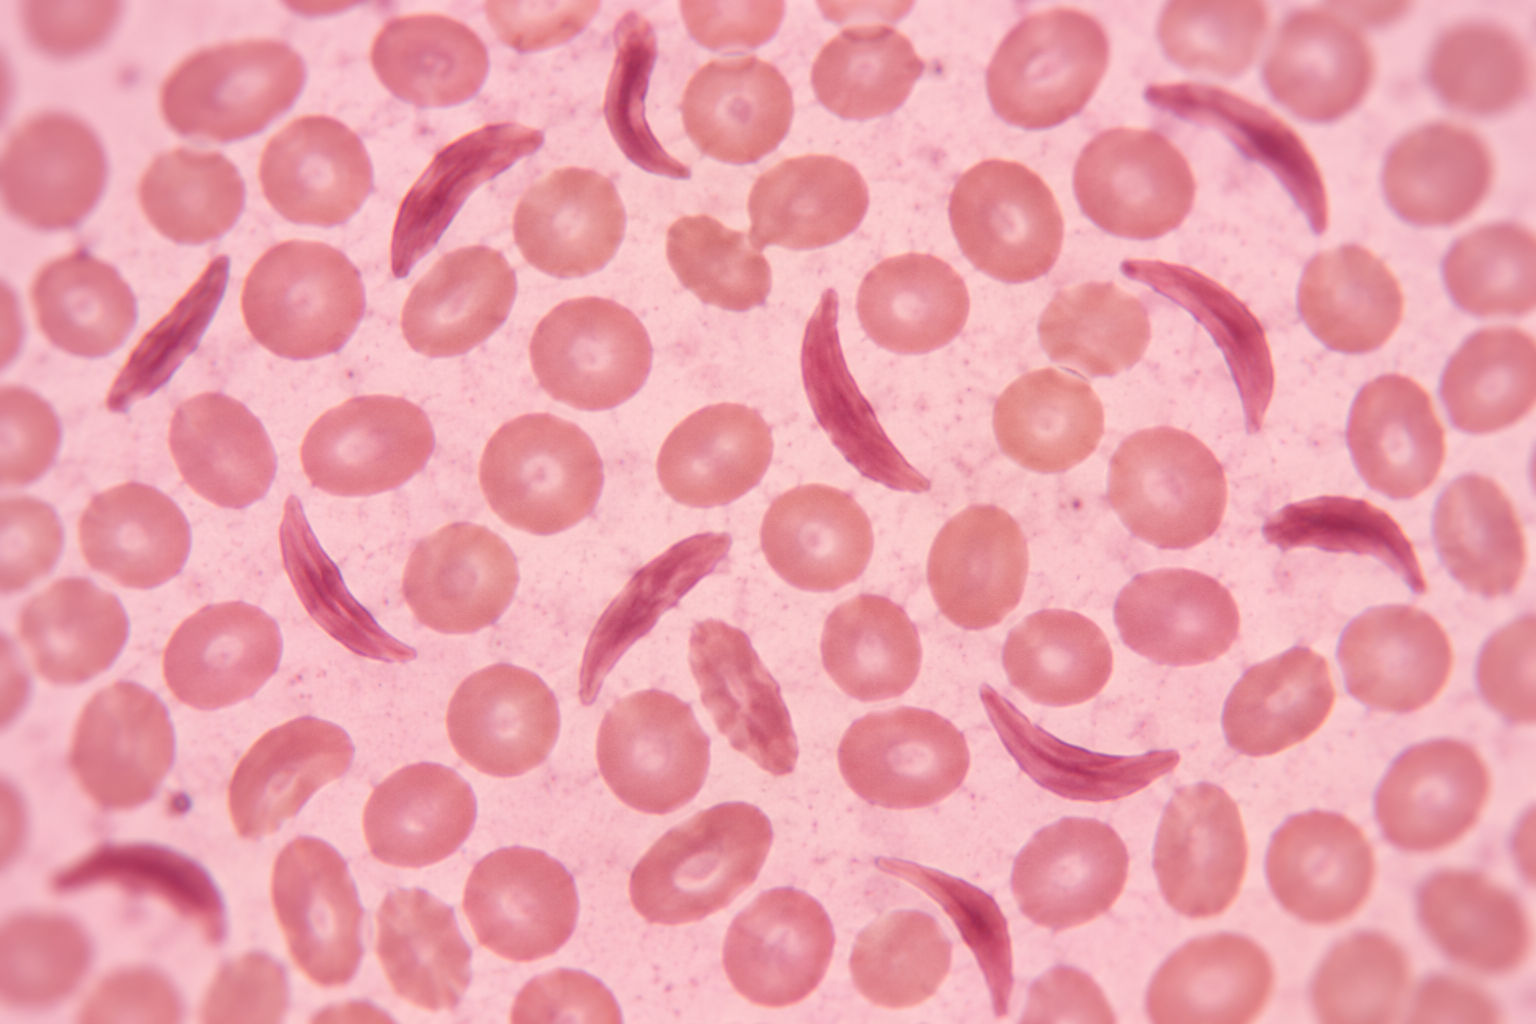
A mesma pergunta aparece em outra escala num hemocentro. Uma gota de sangue vai para um gel sob campo elétrico, e a hemoglobina de uma pessoa com o traço falciforme se separa em duas bandas: a hemoglobina A e a hemoglobina S. A diferença entre as duas proteínas é um aminoácido entre 146. A diferença entre os dois genes é uma letra entre centenas.
As duas cenas têm o mesmo mecanismo por trás: uma sequência de quatro letras, escrita numa molécula, determina a sequência de vinte tipos de aminoácidos em outra molécula. Esta página explica de que são feitos o DNA e o RNA, como a dupla hélice se copia antes de uma divisão celular, como um gene é transcrito em RNA, como o ribossomo traduz o RNA em proteína com a tabela do código genético, por que a célula do seu fígado e a do seu neurônio têm o mesmo DNA e proteínas diferentes, e quanto do seu genoma é, de fato, gene. O que vem antes e depois fica em páginas próprias: o empacotamento do DNA em cromatina e o momento da cópia no ciclo celular estão em núcleo e ciclo celular; o que acontece quando a cópia sai com uma letra errada, em mutações; como os alelos passam de pais para filhos, em leis de Mendel; o dobramento e a função das proteínas prontas, em proteínas e enzimas; os ribossomos e o retículo como organelas, em organelas celulares; os vírus que copiam RNA em DNA, em vírus.
Nucleotídeo: a peça que se repete
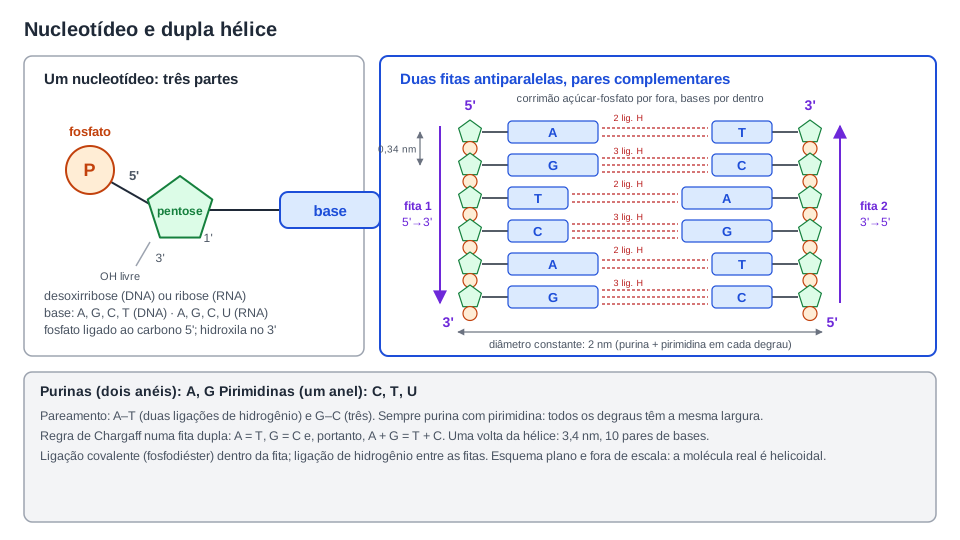
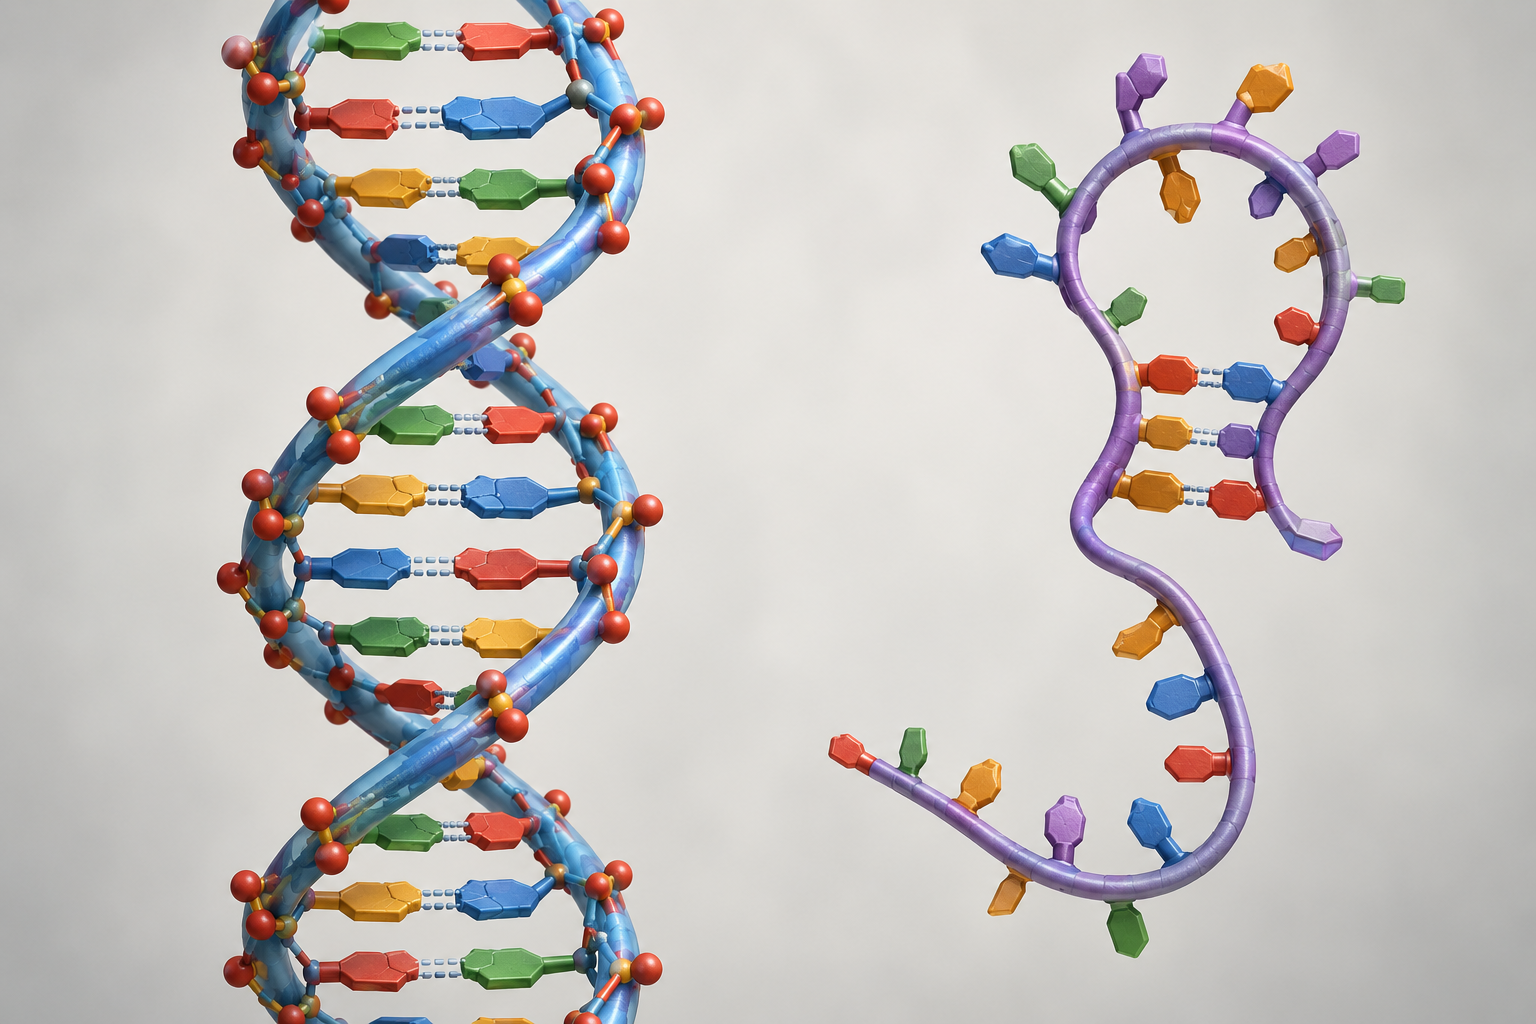
DNA e RNA são ácidos nucleicos: polímeros, como o amido e as proteínas, feitos de uma unidade repetida. A unidade é o nucleotídeo, e cada nucleotídeo tem três partes.
Um grupo fosfato, que dá à molécula o caráter ácido e a carga negativa.
Um açúcar de cinco carbonos, uma pentose: a desoxirribose no DNA e a ribose no RNA. A diferença entre as duas é um átomo de oxigênio no carbono 2 do anel, presente na ribose e ausente na desoxirribose, e é dessa ausência que vem o “desoxi” do nome. As pentoses como açúcares estão em carboidratos.
As bases se dividem em duas famílias pelo tamanho. Purinas têm dois anéis: adenina e guanina. Pirimidinas têm um anel só: citosina, timina e uracila. Guarde o tamanho, porque ele explica o pareamento daqui a pouco.
Os carbonos da pentose são numerados com um apóstrofo, 1’ a 5’, para não confundir com os átomos da base. A base liga-se ao carbono 1’. O fosfato liga-se ao carbono 5’. O carbono 3’ tem uma hidroxila livre. Quando dois nucleotídeos se unem, o fosfato preso ao 5’ de um reage com a hidroxila do 3’ do outro, com saída de água: é a ligação fosfodiéster. Repetida mil vezes, ela forma um corrimão de açúcar e fosfato, sempre alternados, com as bases projetadas para o lado. Uma fita tem, portanto, duas pontas diferentes: a extremidade 5’, com um fosfato livre, e a extremidade 3’, com uma hidroxila livre. Essa polaridade não é detalhe de notação. Toda enzima que copia ou lê um ácido nucleico respeita o sentido 5’ para 3’, e é ela que decide, nas questões de prova, qual fita é lida e em que direção.
Nucleotídeo e fita
Nucleotídeo é a unidade dos ácidos nucleicos: fosfato, pentose (desoxirribose no DNA, ribose no RNA) e base nitrogenada (A, G, C, T no DNA; A, G, C, U no RNA). Purinas (A, G) têm dois anéis; pirimidinas (C, T, U) têm um. Os nucleotídeos se ligam pelo fosfato do carbono 5’ de um à hidroxila do carbono 3’ do seguinte, e a fita resultante tem uma ponta 5’ e uma ponta 3’. A sequência das bases é a informação; o corrimão de açúcar e fosfato é igual em qualquer gene.
Um nucleotídeo que não faz parte de nenhum ácido nucleico aparece em quase todas as outras páginas de biologia: o ATP, adenosina trifosfato, é adenina, ribose e três fosfatos em fila. O mesmo tipo de peça serve de letra no DNA e no RNA e de moeda de energia da célula, assunto de respiração celular.
A peça e a escada. Cada nucleotídeo é fosfato, pentose e base, e os nucleotídeos se ligam pelo fosfato do carbono 5' de um à hidroxila do 3' do seguinte. Na dupla hélice, as duas fitas correm em sentidos opostos e cada degrau é uma purina com uma pirimidina, A com T por duas ligações de hidrogênio e G com C por três. A hélice está desenhada plana e fora de escala. Diagrama autoral.
DNA e RNA: cinco diferenças que decidem itens
A banca cobra as duas moléculas pelo contraste. A tabela reúne o que separa uma da outra.
DNA
RNA
pentose
desoxirribose
ribose
bases
A, G, C, T
A, G, C, U
número de fitas
duas, complementares e antiparalelas, em dupla hélice
uma, que pode dobrar-se sobre si mesma e parear trechos próprios
onde está, na célula eucariótica
núcleo, mitocôndrias e cloroplastos
fabricado no núcleo; trabalha sobretudo no citoplasma
função
guarda e transmite a informação hereditária
copia a informação de um gene (RNAm), transporta aminoácidos (RNAt), forma o ribossomo (RNAr), regula genes
estabilidade
alta: dura a vida da célula e passa às filhas
baixa: um RNAm é degradado em minutos ou horas
Duas linhas da tabela merecem comentário. A primeira é a das bases: a timina é exclusiva do DNA e a uracila é exclusiva do RNA. O PAS 3 de 2020, no bloco das vacinas de RNA, afirmou no item 79 que “o RNA é um ácido nucleico composto pelas quatro bases nitrogenadas A, C, G e T”. Errado: no RNA, a quarta base é U. Uma letra decide o item. A segunda é a do número de fitas. “RNA de fita simples” é a regra, mas uma fita simples pode parear trechos complementares de si mesma e ganhar forma, como o RNA transportador faz, e alguns RNAs são, de fato, de fita dupla, como os RNAs de interferência. O PAS 3 de 2009 (item 85) explorou essa exceção: o texto-base descrevia um RNA de interferência de dupla fita, e o item afirmava que “as moléculas responsáveis por transmitir as instruções contidas nos genes, a exemplo do iRNA, apresentam dupla fita”. Errado por dois motivos. A molécula que leva a instrução do gene ao ribossomo é o RNA mensageiro, e ele é de fita simples. E o RNA de interferência não transmite instrução nenhuma: ele silencia genes, destruindo RNAs mensageiros. O item promove o iRNA a mensageiro e generaliza a dupla fita.
Uma letra, uma molécula
T é do DNA. U é do RNA. Desoxirribose é do DNA. Ribose é do RNA. Fita dupla é a regra do DNA. Fita simples é a regra do RNA, com exceções nomeadas (RNAt dobrado, RNA de interferência de fita dupla, genomas de alguns vírus). Um item que ponha timina no RNA, uracila no DNA ou “dupla fita” no RNA mensageiro está errado. A banca já escreveu o primeiro (PAS 3 2020, item 79) e o terceiro (PAS 3 2009, item 85).
Dupla hélice: por que A com T e C com G
O DNA de uma célula não é uma fita: são duas, enroladas uma na outra numa dupla hélice. O corrimão de açúcar e fosfato fica por fora, voltado para a água. As bases ficam por dentro, empilhadas como degraus de uma escada em caracol, e cada degrau é um par: uma base de cada fita, presas por ligações de hidrogênio. Os pares não são quaisquer. A adenina de uma fita fica sempre diante de uma timina da outra, com duas ligações de hidrogênio. A citosina fica sempre diante de uma guanina, com três. É a complementaridade de bases, e ela vem do tamanho: um par é sempre uma purina (dois anéis) com uma pirimidina (um anel), e só assim todos os degraus têm a mesma largura e a hélice mantém o diâmetro constante de 2 nanômetros. Dois pares de purinas seriam largos demais; dois de pirimidinas, estreitos demais. E, entre as combinações purina-pirimidina, só A com T e G com C têm os átomos na posição certa para as ligações de hidrogênio.
As duas fitas são antiparalelas: uma corre de 5’ para 3’ num sentido, a outra, no sentido oposto. Escreva uma fita como 5’-ATGC-3’ e a parceira fica 3’-TACG-5’. É essa orientação cruzada que as questões de transcrição exigem que você respeite.
Três números descrevem a hélice. Cada par de bases está a 0,34 nm do seguinte. Uma volta completa mede 3,4 nm e contém 10 pares de bases. O diâmetro é de 2 nm. Com o primeiro número e o tamanho do genoma, dá para calcular quanto DNA uma célula guarda, e o exemplo resolvido adiante faz a conta.
A regra de Chargaff, em números
A evidência da complementaridade veio antes do modelo. Em 1950, o bioquímico Erwin Chargaff publicou medidas da proporção das quatro bases em DNA de várias espécies e encontrou duas regularidades. Dentro de cada espécie, a quantidade de adenina é igual à de timina, e a de guanina é igual à de citosina. Entre espécies, a proporção de A + T varia: o DNA humano tem cerca de 60 % de A + T, e outras espécies têm proporções diferentes. A primeira regularidade só faz sentido se cada A estiver pareado com um T e cada G com um C. A segunda mostra que a regra é de pares, e não de quantidades fixas de cada base.
Em prova, a regra vira conta. Como A = T e G = C, basta uma porcentagem para obter as outras três. E, como toda base é purina ou pirimidina, vale também A + G = T + C: o número de purinas é igual ao de pirimidinas numa molécula de fita dupla.
Exemplo resolvido: as quatro porcentagens a partir de uma. Numa amostra de DNA de fita dupla, 22 % das bases são citosina. Quais são as porcentagens de G, A e T?
Citosina pareia com guanina, logo G = C = 22 %. As duas juntas somam 44 %. Sobram 100 − 44 = 56 % para A + T, divididos em partes iguais: A = T = 28 %. Conferência: 22 + 22 + 28 + 28 = 100, e purinas (A + G = 50 %) igualam pirimidinas (T + C = 50 %).
Exemplo resolvido: quando a regra não vale. Numa amostra de RNA, 30 % das bases são A e 18 % são U. Isso contradiz Chargaff?
Não. A regra vale para moléculas de fita dupla, em que cada base tem uma parceira. Um RNA de fita simples não tem parceira base a base, e as proporções são as que a sequência tiver. O mesmo vale para um DNA de fita simples, como o genoma de alguns vírus. Uma amostra em que A ≠ T é, aliás, um sinal de que o material não é DNA de fita dupla.
Uma fotografia e um artigo de uma página
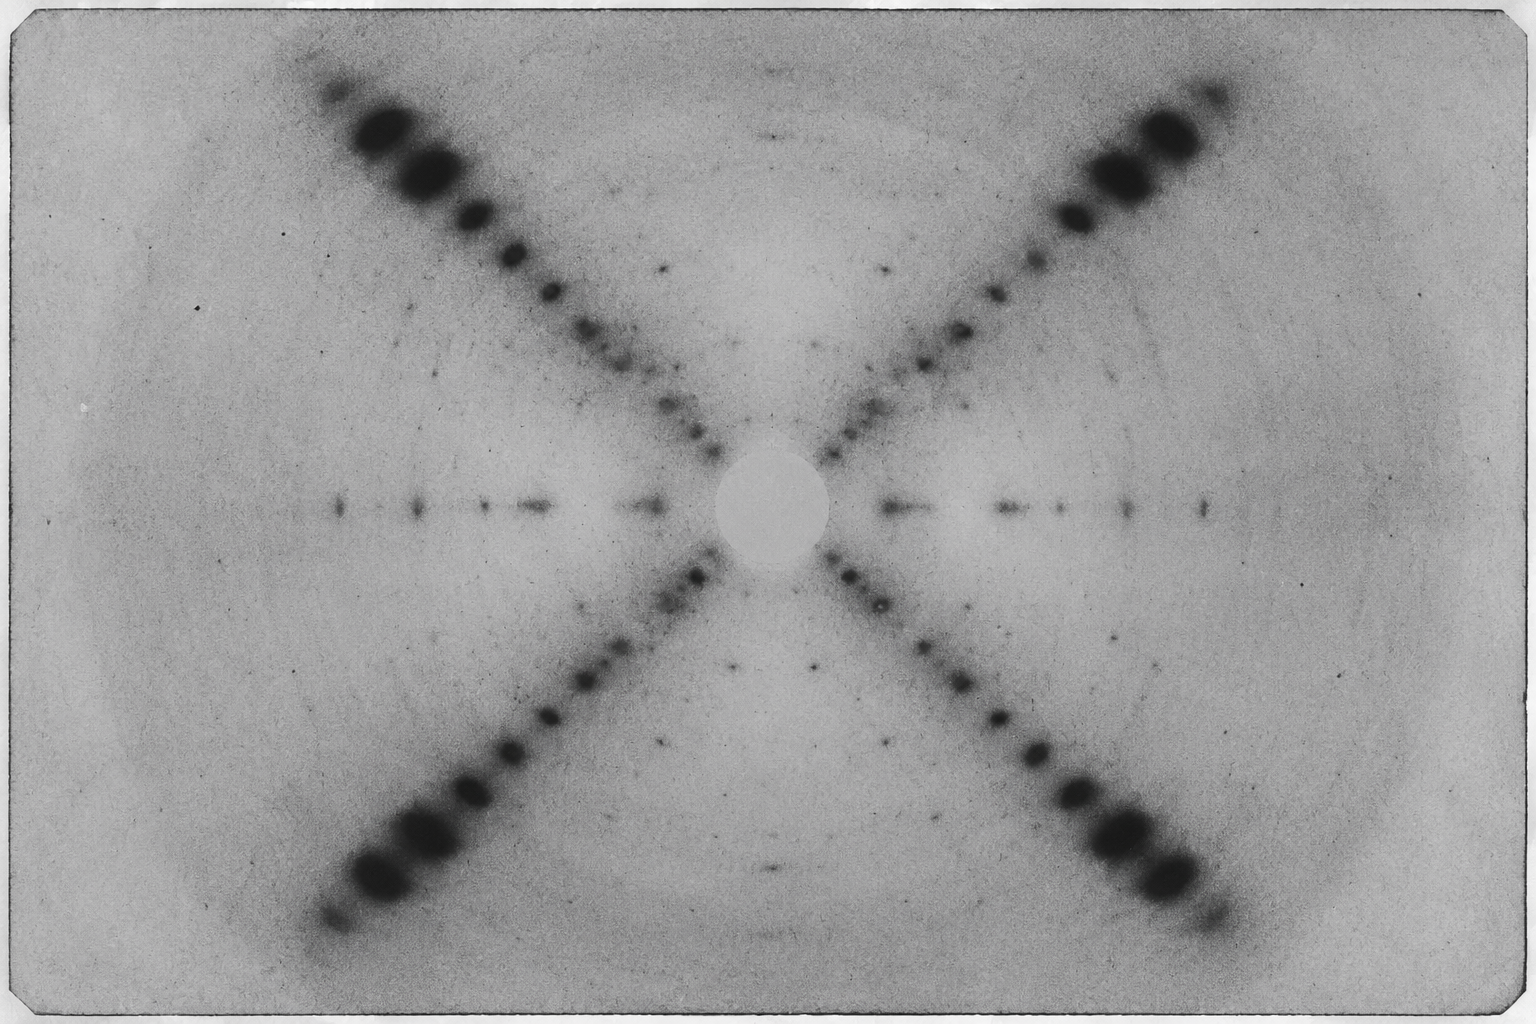
A estrutura foi proposta por James Watson e Francis Crick num artigo de uma página na revista Nature de 25 de abril de 1953. Os dados decisivos vieram da difração de raios X feita no King’s College de Londres por Rosalind Franklin e seu estudante Raymond Gosling, cuja chapa de maio de 1952, conhecida como fotografia 51, mostrava a assinatura de uma hélice, e por Maurice Wilkins. O artigo de Franklin e Gosling saiu na mesma edição da Nature, logo após o de Watson e Crick. Franklin morreu em 1958, aos 37 anos. O Nobel de Fisiologia ou Medicina de 1962 foi para Watson, Crick e Wilkins, “pelas descobertas sobre a estrutura molecular dos ácidos nucleicos e seu significado para a transferência de informação na matéria viva”. O prêmio não é concedido a quem já morreu.
O artigo de 1953 termina com uma frase que vale a página inteira: não escapou aos autores que o pareamento específico sugere de imediato um mecanismo de cópia. Se cada A pede um T e cada G pede um C, cada fita contém a informação para reconstruir a outra. É a próxima seção.
A prova já pediu a arquitetura da molécula pelo tipo de ligação. O PAS 3 de 2010 (item 22), num texto sobre epigenética, afirmou: “As bases nitrogenadas da molécula de DNA que podem ser metiladas estão ligadas à desoxirribose, por meio de ligações covalentes, e a outra base nitrogenada, por meio de ligações de hidrogênio, constituindo, assim, o eixo central da molécula de DNA.” Certo, elo por elo. A ligação base-açúcar, dentro do nucleotídeo, é covalente. A ligação base-base, entre as fitas, é de hidrogênio. E os pares de bases ficam no eixo da hélice, com o corrimão por fora. A frase longa não esconde erro: ela descreve a Figura acima.
Depois de montada, a dupla hélice não fica solta: nas células eucarióticas ela se enrola em proteínas, as histonas, e forma a cromatina, que se compacta em cromossomos na divisão. Esse empacotamento, e a conta de 46 moléculas por célula humana, estão em núcleo e ciclo celular.
Exemplo resolvido: quanto DNA há numa célula. O conjunto haploide humano tem cerca de 3,1 bilhões de pares de bases. Qual é o comprimento total desse DNA esticado? E numa célula diploide?
Cada par de bases ocupa 0,34 nm ao longo da hélice. Comprimento: 3,1×109×0,34nm≈1,05×10⁹nm. Como 1 m = 10⁹ nm, isso dá cerca de 1 metro por conjunto haploide. Uma célula diploide tem dois conjuntos: cerca de 2 metros, repartidos em 46 moléculas, dentro de um núcleo de uns 6 micrômetros. Conferência de ordem de grandeza: o número de pares de bases é da ordem de 10⁹ e o passo é da ordem de 10⁻⁹ m, e o produto é da ordem de 1 m. Se a conta desse 1 cm ou 100 m, houve erro de potência de dez.
Dupla hélice
Duas fitas antiparalelas (uma 5’→3’, a outra 3’→5’), com o corrimão de açúcar e fosfato por fora e os pares de bases por dentro. Pareamento A–T (duas ligações de hidrogênio) e G–C (três), sempre purina com pirimidina. Consequências: regra de Chargaff (A = T, G = C, A + G = T + C), diâmetro constante de 2 nm, 0,34 nm por par de bases, 10 pares por volta de 3,4 nm, e cada fita serve de molde para a outra. Critério para itens: pareamento, antiparalelismo e tipo de ligação (covalente dentro da fita, de hidrogênio entre fitas) são os três pontos a conferir num item.
Replicação: cada fita é molde da outra
Antes de uma célula se dividir, cada molécula de DNA precisa ser copiada inteira, para que as duas células-filhas recebam o mesmo texto. Esse processo é a replicação, e acontece na fase S da interfase, como mostra núcleo e ciclo celular. O mecanismo sai direto da estrutura: as duas fitas se separam, e cada uma serve de molde para a síntese de uma fita nova e complementar. Ao fim, há duas moléculas de DNA, e cada uma tem uma fita antiga e uma fita nova. Por isso a replicação é chamada semiconservativa: metade de cada molécula-filha é conservada da molécula-mãe.
Como se soube que é semiconservativa
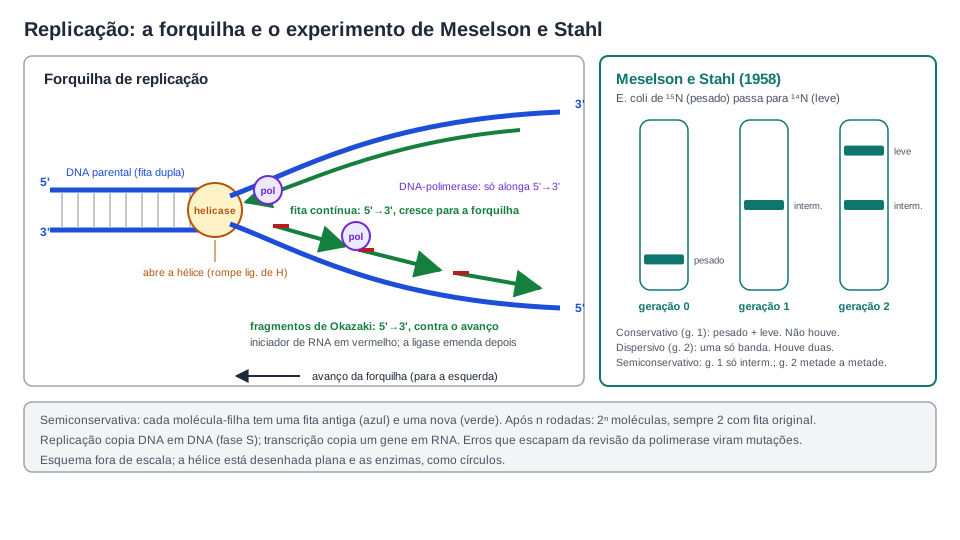
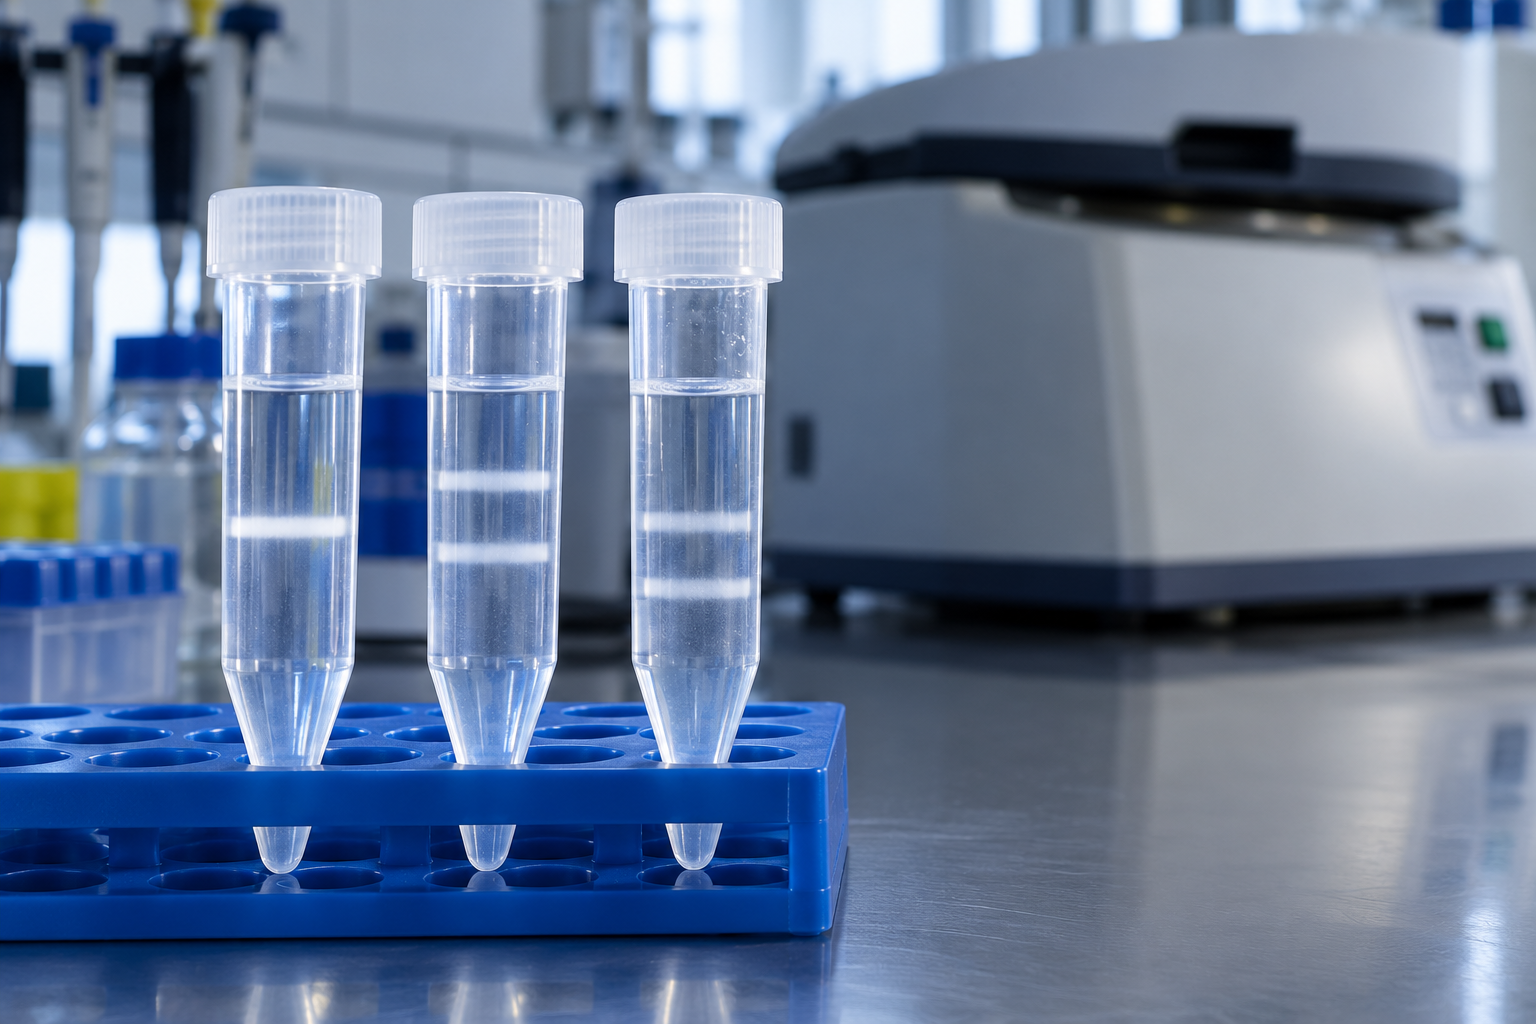
Em 1958, Matthew Meselson e Franklin Stahl publicaram o experimento que decidiu entre três hipóteses. Na hipótese conservativa, a molécula original ficaria intacta e a cópia seria inteiramente nova. Na semiconservativa, cada molécula-filha teria uma fita velha e uma nova. Na dispersiva, cada fita seria um mosaico de trechos velhos e novos. Eles cultivaram a bactéria Escherichia coli por muitas gerações num meio em que o nitrogênio era o isótopo pesado ¹⁵N, de modo que todo o DNA ficou pesado. Depois transferiram as bactérias para um meio com o nitrogênio comum, ¹⁴N, e, a cada geração, extraíram o DNA e o separaram por densidade numa centrífuga.
O resultado foi este. Após uma geração no meio leve, todo o DNA tinha densidade intermediária, entre pesado e leve. Isso elimina a hipótese conservativa, que previa uma banda pesada e uma leve. Após duas gerações, metade do DNA era intermediário e metade era leve. Isso elimina a hipótese dispersiva, que previa uma única banda, cada vez mais leve. Só o modelo semiconservativo prevê exatamente as duas bandas da segunda geração: moléculas com uma fita pesada e uma leve, e moléculas com as duas fitas leves.
A conta que a prova pode pedir sai do mesmo desenho. Uma molécula original gera 2n moléculas após n rodadas de replicação. Como as duas fitas originais nunca são destruídas, apenas separadas, em qualquer geração há exatamente duas moléculas que carregam uma fita original, uma com cada fita. Após 3 rodadas, são 8 moléculas, 2 com uma fita antiga e 6 feitas só de material novo. Após 10 rodadas, são 1 024 moléculas, e ainda 2 com uma fita original.
Como o DNA se copia e como se soube que a cópia é semiconservativa. Na forquilha, a helicase separa as fitas e cada uma serve de molde; como a DNA-polimerase só alonga no sentido 5'→3', uma fita nova cresce contínua e a outra em fragmentos de Okazaki, iniciados por trechos de RNA e emendados pela ligase. Nos tubos de Meselson e Stahl, a banda única intermediária da primeira geração descarta o modelo conservativo, e as duas bandas da segunda descartam o dispersivo. Esquema fora de escala. Diagrama autoral.
As enzimas, no nível que a prova usa
A cópia é feita por um conjunto de proteínas, e quatro nomes bastam para o ensino médio.
A helicase separa as duas fitas, rompendo as ligações de hidrogênio entre as bases. O ponto em que as fitas se abrem e a cópia avança é a forquilha de replicação. Em cromossomos longos, a replicação começa em milhares de pontos ao mesmo tempo, e cada ponto abre duas forquilhas.
A DNA-polimerase monta a fita nova, encaixando nucleotídeos complementares ao molde, um por vez, sempre no sentido 5’→3’ da fita nova. A enzima foi isolada por Arthur Kornberg nos anos 1950, trabalho que lhe valeu o Nobel de 1959 com Severo Ochoa. Ela tem duas limitações que decidem o desenho da forquilha: só alonga uma cadeia já começada, e só no sentido 5’→3’.
Por causa da primeira limitação, uma primase sintetiza um pequeno trecho de RNA, o iniciador (primer), que dá à polimerase um ponto de partida. Os iniciadores são removidos e substituídos por DNA no fim.
Por causa da segunda limitação, as duas fitas novas não crescem do mesmo jeito. Como as fitas-molde são antiparalelas e a forquilha avança num sentido só, uma fita nova é feita de modo contínuo, acompanhando a forquilha, e a outra em pedaços curtos, os fragmentos de Okazaki, feitos no sentido contrário ao avanço e depois unidos pela DNA-ligase.
A DNA-polimerase também revisa o próprio trabalho: ao inserir uma base errada, ela recua, remove a base e tenta de novo. Com a revisão e os sistemas de reparo que agem depois, a taxa de erro final fica muito baixa. Os erros que escapam são a origem das mutações, assunto de mutações. O PAS 3 de 2024 (item 45) afirmou que “a resistência a antibióticos pode surgir por uma mutação no DNA bacteriano que ocorre durante o processo de replicação do DNA”. Certo: a replicação é a fonte mais comum de mutações, e numa colônia de bilhões de bactérias, cada uma copiando o genoma a cada vinte minutos, os erros raros acabam aparecendo.
Replicação
Cópia de DNA em DNA, antes da divisão celular (fase S). Semiconservativa: cada molécula nova tem uma fita antiga e uma nova (Meselson e Stahl, 1958). Helicase abre a dupla hélice; primase põe um iniciador de RNA; DNA-polimerase alonga a fita nova só no sentido 5’→3’ e revisa; uma fita cresce contínua e a outra em fragmentos de Okazaki, unidos pela ligase. Após n rodadas, 2n moléculas, e sempre 2 com uma fita original. Critério para itens: “replicação” copia DNA, “transcrição” copia um gene em RNA; o verbo errado derruba a frase.
Replicação não é transcrição
Os dois processos copiam DNA, e trocar um pelo outro é o erro de vocabulário a vigiar. Na replicação, o molde é a molécula inteira, o produto é DNA de fita dupla, a enzima é a DNA-polimerase e o momento é a fase S. Na transcrição, o molde é um gene, o produto é um RNA de fita simples, a enzima é a RNA-polimerase e o momento é qualquer hora em que a célula precise daquela proteína. Um erro de replicação em célula germinativa é herdado; um erro de transcrição produz um RNA defeituoso, que é descartado, e não passa a ninguém. A diferença entre os dois erros está em mutações.
O dogma central: a informação desce, e o caminho de volta não existe
Um gene é um trecho de DNA cuja sequência de bases contém a informação para fabricar um produto. Na maioria dos casos o produto é uma proteína; em outros, é um RNA que trabalha como RNA (o transportador e o ribossômico são os exemplos clássicos). O caminho do gene à proteína tem duas etapas com nome próprio. Na transcrição, a sequência do gene é copiada numa molécula de RNA mensageiro. Na tradução, o ribossomo lê o RNA mensageiro e monta a cadeia de aminoácidos. O conjunto, DNA → RNA → proteína, foi chamado por Francis Crick de dogma central da biologia molecular, num texto de 1958 e reformulado por ele num artigo de 1970 na Nature. O nome é infeliz, e o próprio Crick reconheceu: não é um dogma, é uma afirmação sobre que transferências de informação são possíveis.
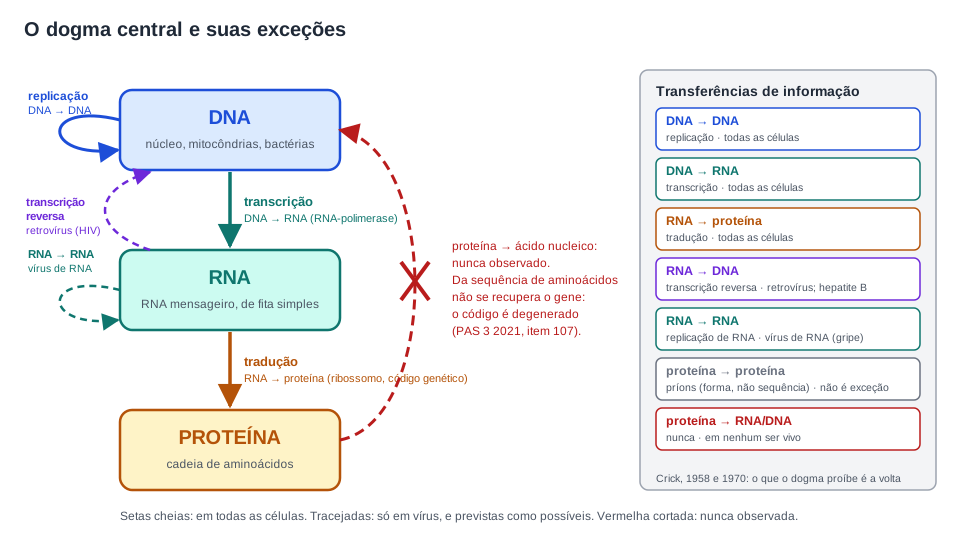
O que o dogma diz, na versão de 1970, é mais preciso do que “DNA faz RNA faz proteína”. A informação em sequência pode passar de ácido nucleico para ácido nucleico (DNA → DNA, na replicação; DNA → RNA, na transcrição) e de ácido nucleico para proteína (RNA → proteína, na tradução). O que nunca foi observado, e Crick previu que não seria, é a informação voltar de proteína para ácido nucleico: nenhuma célula lê uma proteína e escreve o gene correspondente. Isso tem uma razão que a próxima seção explica: como vários códons indicam o mesmo aminoácido, a sequência de uma proteína não determina uma única sequência de gene. O PAS 3 de 2021 (item 107) afirmou que “a partir da sequência de aminoácidos de uma proteína, é possível determinar a sequência do respectivo gene”. Errado: dada a proteína, há muitas sequências de gene compatíveis, e nenhuma máquina celular faz esse caminho.
As exceções que a prova conhece
Três transferências fora da seta principal existem, e nenhuma contradiz a formulação de 1970.
RNA → DNA, a transcrição reversa. Em 1970, Howard Temin e David Baltimore mostraram, de forma independente, que certos vírus de RNA carregam uma enzima que copia RNA em DNA, a transcriptase reversa. O HIV é o exemplo: seu RNA é copiado em DNA, que se integra ao cromossomo da célula e só então é transcrito. O achado valeu o Nobel de 1975 (com Renato Dulbecco) e está detalhado em vírus. É uma transferência de ácido nucleico para ácido nucleico, prevista como possível por Crick.
RNA → RNA. Vírus de RNA que não são retrovírus, como os da gripe, da dengue e da covid-19, copiam o próprio RNA com uma polimerase que a célula não tem e que o vírus carrega ou manda fabricar. Também é ácido nucleico para ácido nucleico.
Proteína → proteína, os príons. Uma proteína com dobramento anormal pode induzir cópias normais da mesma proteína a adotar o dobramento anormal, como nas encefalopatias espongiformes. Não há sequência nova sendo escrita: a sequência das duas é a mesma, e o que se propaga é a forma. Por isso o caso não é uma exceção ao dogma, que trata de informação em sequência.
O que não existe, em nenhum ser vivo nem vírus conhecido, é proteína → RNA ou proteína → DNA.
O fluxo da informação em sequência. Nas células, DNA é copiado em DNA, transcrito em RNA e traduzido em proteína. Em vírus, RNA pode ser copiado em DNA pela transcriptase reversa e RNA em RNA por uma polimerase viral, transferências entre ácidos nucleicos que a formulação de Crick admite. O que nunca foi observado é a volta: de uma proteína não se escreve um gene, e é isso que o dogma proíbe. Diagrama autoral.
O caminho de mão única apareceu em dois itens de 2020, no bloco das vacinas de RNA contra a covid-19. O texto-base contava que notícias falsas espalharam o boato de que as vacinas “alterariam o DNA humano”. O item 77 afirmava que “o RNA mensageiro presente na vacina contra a covid-19 se insere no DNA do hospedeiro para torná-lo imune à doença”. Errado. O RNA mensageiro da vacina é traduzido no citoplasma e degradado; a célula humana não tem transcriptase reversa para copiá-lo em DNA, e ele não entra no núcleo. O item 78 trazia a versão correta: “o processo de tradução do RNA mensageiro viral no citoplasma das células humanas produz proteínas idênticas às encontradas no vírus, que serão, então, reconhecidas pelo sistema imune humano”. Certo. O ribossomo humano lê qualquer RNA mensageiro com a mesma tabela, de onde quer que ele venha, e a proteína resultante é a viral. Como o sistema imune responde a ela está em vacinas e soros.
O PAS 3 de 2012 (item 27) usou o dogma para julgar a hipótese do mundo de RNA, a ideia de que a vida começou com moléculas de RNA que guardavam informação e catalisavam reações, antes de existirem DNA e proteínas. O item perguntava por que a hipótese “não se encaixa bem” com o que se sabe dos seres atuais, e a resposta era que “os processos de transcrição e tradução são dependentes de enzimas”. Nos seres de hoje, copiar e traduzir exige proteínas, e proteínas só existem depois da tradução. É o ovo e a galinha que o mundo de RNA tenta resolver, e que o sistema atual, sozinho, não explica. As outras opções (código degenerado, tradução dependente de RNA transportador, informação conduzida por RNA mensageiro) são fatos do sistema atual que não contradizem a hipótese; RNAt e RNAm são RNAs. A discussão da origem está em origem da vida.
Dogma central
Transferências de informação em sequência observadas nos seres vivos: DNA → DNA (replicação), DNA → RNA (transcrição), RNA → proteína (tradução); e, em vírus, RNA → DNA (transcrição reversa) e RNA → RNA. Nunca observada: proteína → ácido nucleico. Critério para itens: “o RNAm se insere no DNA” é errado (2020/77); “da proteína se determina o gene” é errado (2021/107); “o retrovírus derruba o dogma” é errado, porque RNA → DNA é transferência entre ácidos nucleicos, admitida desde 1958.
Transcrição: copiar um gene em RNA
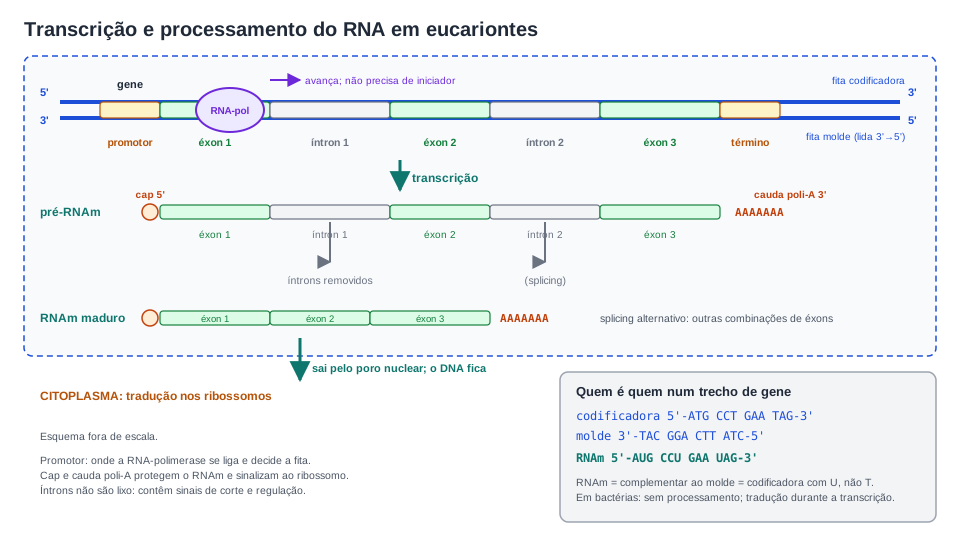
A transcrição produz um RNA a partir de um trecho de DNA. A enzima é a RNA-polimerase. Ela reconhece, antes do gene, uma sequência chamada promotor, que diz onde começar e qual fita usar; abre a dupla hélice num trecho curto; e vai encaixando ribonucleotídeos complementares a uma das fitas, no sentido 5’→3’ do RNA que cresce. Ao contrário da DNA-polimerase, ela não precisa de iniciador. Quando chega a um sinal de término, solta o RNA e a dupla hélice se fecha de novo. O DNA não sai do núcleo em momento algum: o que sai é a cópia.
Só uma das duas fitas do gene é copiada, e ela tem dois nomes.
A fita molde é a que a RNA-polimerase lê. O RNA é complementar a ela: onde o molde tem A, o RNA recebe U; onde tem T, recebe A; onde tem G, recebe C; onde tem C, recebe G.
A fita codificadora é a outra. Como ela é complementar ao molde, e o RNA também, o RNA tem a mesma sequência da fita codificadora, com U no lugar de T. É dela que se lê o gene nos bancos de dados, e é por isso que o nome “código” aparece nela.
Como as fitas são antiparalelas e o RNA cresce de 5’ para 3’, a fita molde é lida de 3’ para 5’. É esse o ponto que decide as questões de transcrição: a resposta certa exige saber qual fita foi dada e em que sentido ela está escrita.
Exemplo resolvido: do molde ao RNA. A fita molde de um trecho de gene é 3’-TAC GGA CTT ATC-5’. Escreva o RNA mensageiro e a fita codificadora.
O RNA é complementar ao molde e antiparalelo a ele, logo começa pela ponta 5’: 5’-AUG CCU GAA UAG-3’. A fita codificadora tem a mesma sequência do RNA com T no lugar de U: 5’-ATG CCT GAA TAG-3’. Conferência: a codificadora é complementar ao molde posição a posição (A com T, T com A, G com C, C com G) e antiparalela a ele.
Se o enunciado desse a fita codificadora, o caminho seria mais curto: troca-se T por U e mantém-se a orientação. Se desse “uma fita” sem dizer qual, a questão está mal feita, e vale assumir o que o contexto indicar, em geral que a fita dada é o molde.
Em eucariontes, o RNA sai processado
Em bactérias, o RNA transcrito já é o mensageiro, e os ribossomos começam a traduzi-lo enquanto a RNA-polimerase ainda o fabrica, porque não há núcleo separando os dois processos. Em eucariontes, o produto da transcrição é um pré-RNA mensageiro, que passa por três modificações dentro do núcleo antes de sair.
Na ponta 5’, recebe um nucleotídeo modificado, o cap, que protege o RNA e serve de sinal para o ribossomo.
Na ponta 3’, recebe uma cauda de poli-A, dezenas a centenas de adeninas, que também protege e regula a duração do RNA.
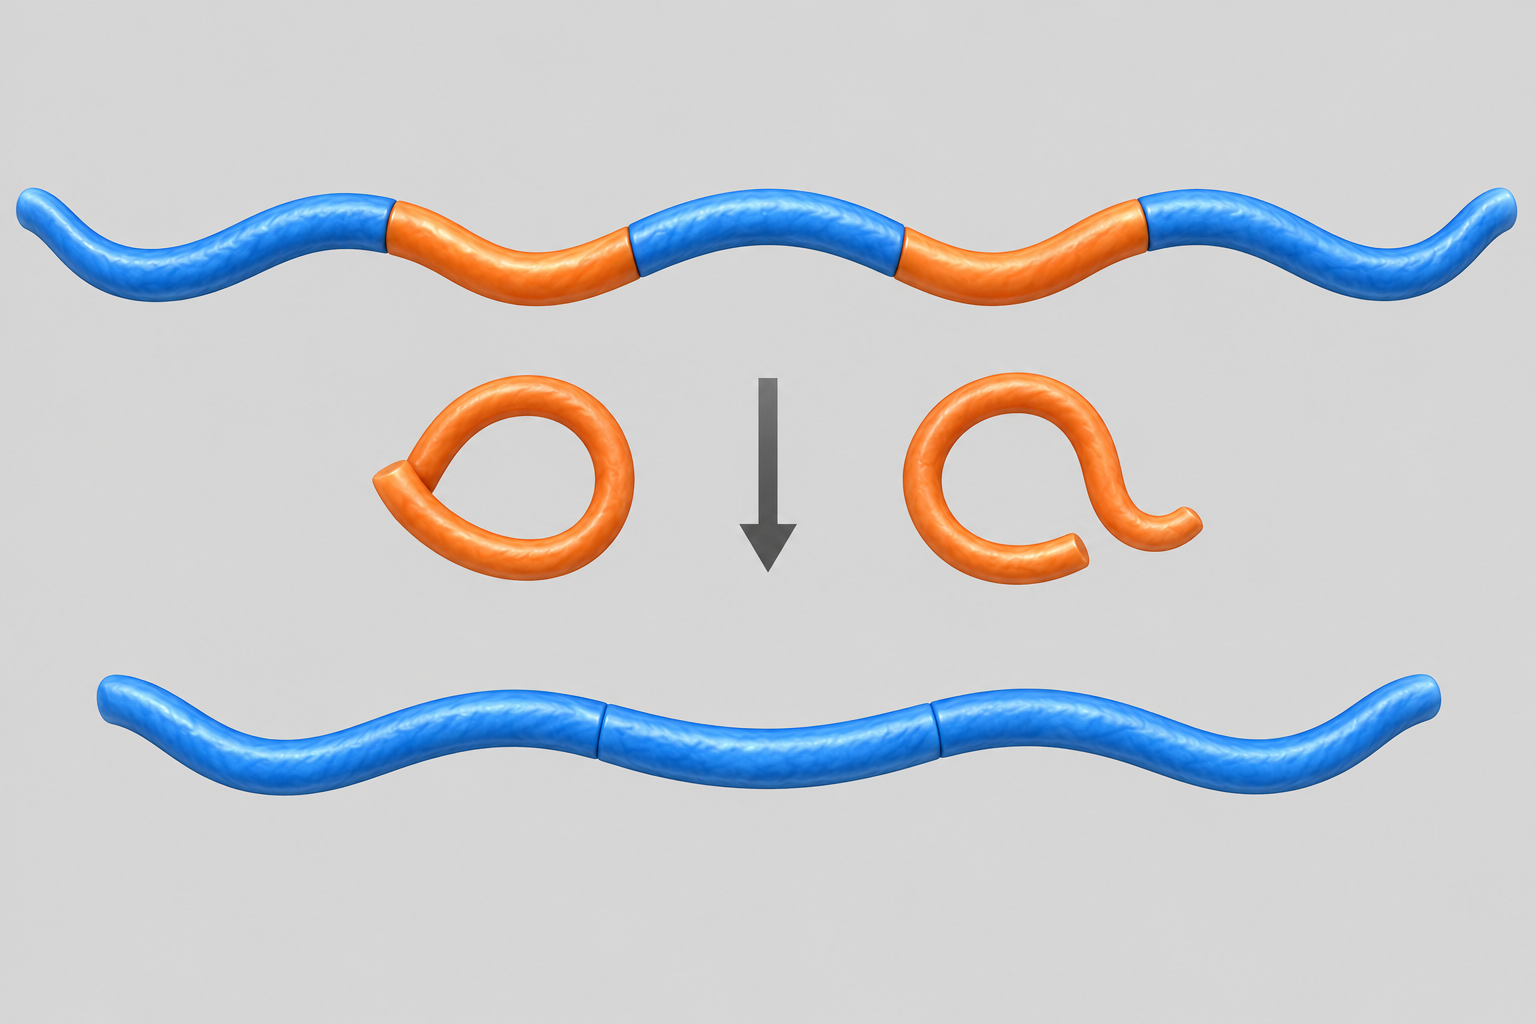
No meio, perde os íntrons. Os genes eucarióticos são interrompidos: trechos que codificam a proteína, os éxons, alternam com trechos que não codificam, os íntrons. Os dois são transcritos, mas os íntrons são cortados e os éxons são emendados, num processo chamado splicing. Só então o RNA mensageiro maduro atravessa os poros do núcleo para o citoplasma.
Os genes interrompidos foram descobertos em 1977 por Phillip Sharp e Richard Roberts, em grupos independentes que estudavam um adenovírus, achado que valeu o Nobel de 1993. A consequência mais importante é o splicing alternativo: a célula pode emendar os éxons de um mesmo gene de modos diferentes e produzir mais de uma proteína a partir dele. É uma das razões de o número de proteínas humanas ser bem maior que o número de genes.
Um erro comum é chamar os íntrons de lixo. Eles não codificam proteína, mas contêm sinais que regulam onde e como o splicing acontece, e mutações em íntrons podem causar doença ao desarranjar o corte. A escala do que codifica e do que não codifica no genoma está na seção sobre o genoma humano.
Do gene ao RNA mensageiro maduro. A RNA-polimerase se liga ao promotor, lê a fita molde no sentido 3'→5' e monta um RNA igual à fita codificadora, com U no lugar de T. Em eucariontes, o pré-RNAm ganha o cap na ponta 5' e a cauda poli-A na ponta 3' e perde os íntrons; os éxons emendados saem pelo poro nuclear, e o DNA fica no núcleo. Esquema fora de escala. Diagrama autoral.
Transcrição
Síntese de RNA a partir de um gene, pela RNA-polimerase, que começa no promotor, lê a fita molde no sentido 3’→5’ e monta o RNA 5’→3’, complementar ao molde e igual à fita codificadora com U no lugar de T. Em eucariontes, no núcleo, o pré-RNAm recebe cap e cauda poli-A e perde os íntrons (splicing); em procariontes, não há processamento e a tradução começa durante a transcrição. Critério para itens: o DNA fica no núcleo; o que sai é o RNAm.
Três RNAs, três trabalhos
O produto da transcrição depende do gene. Três tipos de RNA fazem a síntese de proteínas acontecer, e é preciso saber o nome e a função de cada um.
RNA
o que é
o que faz
mensageiro (RNAm)
cópia de fita simples de um gene; os códons são lidos nele
leva a sequência do gene até o ribossomo e é traduzido
transportador (RNAt)
molécula curta, dobrada em forma de trevo, com um anticódon numa ponta e um aminoácido preso na outra
traz o aminoácido certo para cada códon; faz a correspondência entre a linguagem dos nucleotídeos e a dos aminoácidos
ribossômico (RNAr)
RNA longo, transcrito no nucléolo, associado a proteínas
forma o ribossomo; é o RNAr, e não uma proteína, que catalisa a ligação peptídica
O RNA transportador merece uma linha a mais, porque é o adaptador que torna o código possível. Cada RNAt tem um anticódon, uma trinca de bases que pareia com um códon do mensageiro, e carrega na outra extremidade o aminoácido correspondente àquele códon. Quem prende o aminoácido certo ao RNAt certo é uma família de enzimas, as aminoacil-RNAt sintetases, uma para cada aminoácido. O anticódon é complementar e antiparalelo ao códon, e não igual a ele: o códon 5’-AUG-3’ pareia com o anticódon 3’-UAC-5’. A estrutura do primeiro RNAt foi determinada por Robert Holley em 1965.
O ribossomo tem duas subunidades, cada uma com RNAr e proteínas, montadas no nucléolo e unidas só no citoplasma, em torno de um RNA mensageiro. O das bactérias é o 70S; o do citosol eucariótico, o 80S; mitocôndrias e cloroplastos têm ribossomos do tipo bacteriano. A estrutura e a diferença entre ribossomos livres e aderidos ao retículo estão em organelas celulares.
Há ainda RNAs pequenos que não participam da síntese e sim do controle dela: os microRNAs e os RNAs de interferência pareiam com RNAs mensageiros e os marcam para destruição ou bloqueio. É a esse grupo que pertencia o RNA de fita dupla do item de 2009. A interferência por RNA, descrita em 1998, valeu o Nobel de 2006 a Andrew Fire e Craig Mello.
O código genético: 64 códons para 20 aminoácidos
A tradução exige uma tabela de correspondência entre a linguagem de quatro letras dos ácidos nucleicos e a de vinte letras das proteínas. Essa tabela é o código genético. A unidade de leitura é o códon: uma trinca de bases do RNA mensageiro. O PAS 3 de 2020 (item 80) cobrou o vocabulário ao pé da letra: “As trincas de base do RNA mensageiro são denominadas códons.” Certo.
Por que trincas? Com uma base por aminoácido haveria só 4 combinações; com duas, 42=16, ainda menos que 20. Com três, 43=64, mais que suficiente. A natureza usa trincas, e o excesso de combinações tem consequência.
Como se lê a tabela
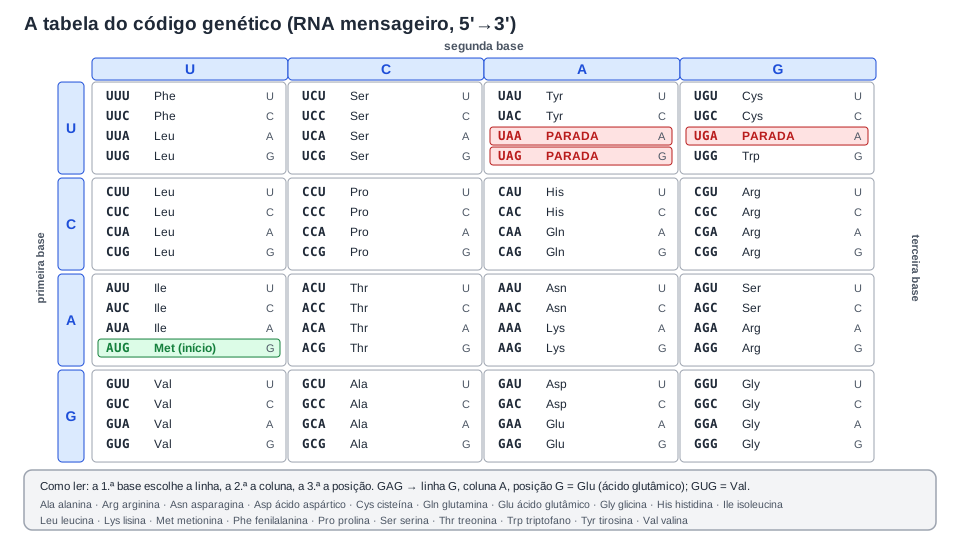
A tabela do código genético é organizada pelas três bases do códon: a primeira escolhe a linha, a segunda escolhe a coluna, a terceira escolhe a posição dentro da célula da tabela. O códon GAG, por exemplo, está na linha G, coluna A, posição G, e corresponde ao ácido glutâmico (Glu). O códon GUG está na linha G, coluna U, posição G: valina (Val). A prova imprime a tabela quando precisa dela; o que você precisa saber é lê-la e três códons de cor.
AUG é o códon de início: toda tradução começa num AUG, e ele codifica a metionina. Por isso a maioria das cadeias nasce com metionina na primeira posição, que pode ser removida depois.
UAA, UAG e UGA são os três códons de parada (ou de término). Não correspondem a aminoácido algum: quando o ribossomo chega a um deles, a cadeia é liberada.
Os outros 61 códons (64 menos 3) codificam os 20 aminoácidos, e é daí que saem as quatro propriedades que a prova julga.
Os 64 códons e seus significados. A primeira base escolhe a linha, a segunda a coluna, a terceira a posição dentro da célula. AUG inicia a leitura e codifica metionina; UAA, UAG e UGA encerram; os outros 61 códons codificam 20 aminoácidos, quase todos por mais de um códon, e os sinônimos costumam diferir só na terceira base. Diagrama autoral.
Quatro propriedades
Degenerado, ou redundante. Como há 61 códons para 20 aminoácidos, a maioria dos aminoácidos é indicada por mais de um códon. A leucina, a serina e a arginina têm seis cada; a valina tem quatro (GUU, GUC, GUA, GUG); a metionina e o triptofano têm um só. Os códons sinônimos costumam diferir na terceira base, e uma troca nessa posição muitas vezes não muda o aminoácido. É a base das mutações silenciosas, assunto de mutações, e é a razão de o caminho proteína → gene não existir: Pro-Val-Glu pode ter vindo de dezenas de sequências diferentes.
Não ambíguo. Cada códon indica um único aminoácido, ou a parada. Degenerado e ambíguo não são sinônimos: vários códons para um aminoácido é degeneração; um códon para vários aminoácidos seria ambiguidade, e isso o código não tem. Um item que diga “o código é ambíguo” ou “um códon pode especificar aminoácidos diferentes” está errado.
Quase universal. A mesma tabela vale para bactérias, plantas, fungos e animais, o que permite que uma célula humana traduza o RNA de um vírus, que uma bactéria produza insulina humana e que o gene de uma espécie funcione em outra. As exceções são poucas e pequenas: nas mitocôndrias dos vertebrados, por exemplo, UGA codifica triptofano em vez de parada, e alguns ciliados leem UAA e UAG como glutamina.
Sem sobreposição e sem vírgulas. O ribossomo lê os códons um após o outro, sem pular bases e sem reler bases. Uma vez fixado o AUG inicial, o quadro de leitura está definido. Inserir ou retirar uma base desloca o quadro e muda todos os aminoácidos dali em diante.
Como o código foi decifrado
Em 1961, Marshall Nirenberg e Heinrich Matthaei fabricaram um RNA artificial feito só de uracila, poli-U, e o puseram num extrato de bactérias com os vinte aminoácidos. O extrato produziu uma cadeia feita só de fenilalanina. UUU, portanto, codifica fenilalanina: foi a primeira palavra do código. Nos anos seguintes, Nirenberg e Har Gobind Khorana, com RNAs sintéticos de sequência conhecida, preencheram os 64 códons, e Robert Holley determinou a estrutura do RNA transportador. Os três dividiram o Nobel de 1968, “pela interpretação do código genético e sua função na síntese de proteínas”.
Exemplo resolvido: traduzir uma sequência. O RNA mensageiro 5’-AUG CCU GAA UAG-3’ é traduzido. Com a tabela (AUG = Met, CCU = Pro, GAA = Glu, UAG = parada), qual é o peptídeo e quantos aminoácidos ele tem?
Leitura de três em três a partir do AUG: Met, Pro, Glu, parada. O peptídeo é Met-Pro-Glu, com 3 aminoácidos. O quarto códon é de parada e não acrescenta aminoácido. Conferência pela conta: 12 bases formam 4 códons; descontado o de parada, 3 aminoácidos.
Exemplo resolvido: quantos aminoácidos cabem num gene. Um trecho codificador tem 303 pares de bases, do AUG ao códon de parada inclusive. Quantos aminoácidos tem a proteína?
303÷3=101 códons. Um deles é o de parada, que não codifica aminoácido: 100 aminoácidos. Em geral, um trecho de n bases que termina num códon de parada codifica n/3−1 aminoácidos. Conferência: 100 aminoácidos pedem 100 códons, mais 1 de parada, 101 códons, 303 bases.
Código genético
Tabela que liga cada um dos 64 códons (trincas de bases do RNAm) a um dos 20 aminoácidos ou a um sinal de parada. AUG = início e metionina; UAA, UAG, UGA = parada; 61 códons codificam aminoácidos. Degenerado (vários códons por aminoácido), não ambíguo (um códon, um aminoácido), quase universal (com exceções mitocondriais), lido sem sobreposição a partir do AUG. Decifrado a partir de 1961 (Nirenberg e Matthaei, poli-U → fenilalanina; Nobel de 1968 com Khorana e Holley). Conta de bolso: n bases com códon de parada ao fim dão n/3−1 aminoácidos.
Degenerado não é ambíguo
“Um aminoácido pode ser codificado por vários códons” é certo e se chama degeneração. “Um códon pode codificar vários aminoácidos” é errado e se chamaria ambiguidade. O PAS 3 de 2012 (item 27) listou a propriedade pelo nome completo, “degenerado, redundante e não ambíguo”, como uma opção verdadeira que não respondia à pergunta. E “cada aminoácido tem um só códon” é errado para 18 dos 20: só metionina e triptofano têm códon único.
Tradução: o ribossomo lê de três em três
A tradução é a montagem da cadeia de aminoácidos a partir do RNA mensageiro. Acontece no citoplasma, nos ribossomos, e tem três fases.
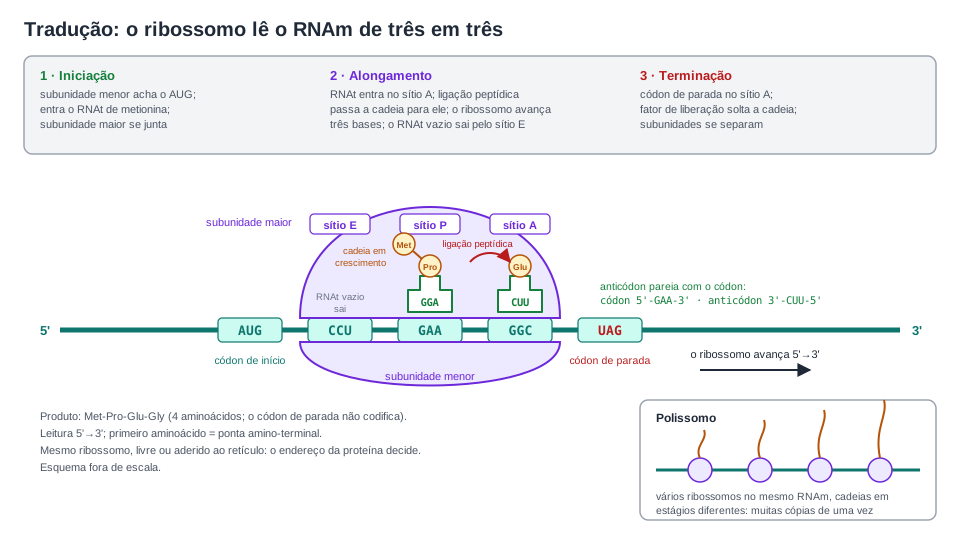
Iniciação. A subunidade menor do ribossomo se liga ao RNA mensageiro perto da ponta 5’ (em eucariontes, reconhece o cap) e desliza até encontrar o primeiro AUG. Um RNAt carregando metionina, com o anticódon UAC, pareia com esse AUG. A subunidade maior se junta, e o ribossomo completo fica com o RNAt da metionina no seu sítio central.
Alongamento. O ribossomo tem três sítios para RNAt, chamados A, P e E. No sítio A entra o RNAt cujo anticódon pareia com o códon seguinte, trazendo o aminoácido seguinte. O sítio P segura o RNAt preso à cadeia que está crescendo. A subunidade maior catalisa a ligação peptídica entre o aminoácido do sítio A e a cadeia do sítio P, e a cadeia inteira passa para o RNAt do sítio A. O ribossomo então avança três bases no sentido 5’→3’ do mensageiro: o RNAt que ficou vazio vai para o sítio E e sai; o que carrega a cadeia passa para o sítio P; o sítio A fica livre para o próximo. Cada ciclo acrescenta um aminoácido e gasta energia, fornecida por GTP.
Terminação. Quando um códon de parada chega ao sítio A, nenhum RNAt pareia com ele. Uma proteína chamada fator de liberação entra no lugar, a cadeia é solta do último RNAt, e as subunidades do ribossomo se separam, prontas para outro mensageiro.
Como a leitura é feita a partir da ponta 5’ do mensageiro, o primeiro aminoácido da cadeia é o da ponta chamada amino-terminal (N-terminal), e o último, o da ponta carboxi-terminal (C-terminal). Um item que diga que o ribossomo lê o mensageiro de 3’ para 5’ está errado.
Um mesmo RNA mensageiro é lido por vários ribossomos ao mesmo tempo, um atrás do outro, cada um com uma cadeia em estágio diferente. O conjunto chama-se polissomo, e é assim que a célula fabrica muitas cópias de uma proteína em paralelo a partir de uma cópia do gene. Em micrografias, um polissomo aparece como um colar de grânulos sobre um fio.
Um ciclo de alongamento visto de dentro. O RNAt do sítio P segura a cadeia; o RNAt que chega ao sítio A traz o aminoácido do códon seguinte, pareado pelo anticódon; o ribossomo forma a ligação peptídica, avança três bases e libera o RNAt vazio pelo sítio E. A leitura começa no AUG e termina num códon de parada, e vários ribossomos lendo o mesmo RNAm formam um polissomo. Esquema fora de escala. Diagrama autoral.
Onde a tradução acontece, e por que isso importa
Todo ribossomo começa a traduzir livre no citosol. Se os primeiros aminoácidos da cadeia formam um sinal de endereçamento, o ribossomo é levado até o retículo endoplasmático rugoso e continua o trabalho preso a ele, e a proteína cresce para dentro do retículo, de onde seguirá para secreção, para a membrana ou para os lisossomos. Se não há sinal, a tradução termina no citosol, e a proteína fica lá, vai para o núcleo ou para a mitocôndria. Os dois tipos de ribossomo são iguais; o destino da proteína é que muda. O PAS 3 de 2025 (item 70), num texto sobre o cupuaçu, afirmou que a produção de proteínas no fruto “ocorre no citoplasma celular, tanto em ribossomos livres quanto naqueles associados ao retículo endoplasmático rugoso, mecanismo geral similar ao observado em animais como os seres humanos”. Certo: a maquinaria de tradução é a mesma em todos os eucariontes. Os detalhes estão em organelas celulares.
A diferença entre o ribossomo bacteriano (70S) e o eucariótico (80S) é a base de uma classe inteira de antibióticos. Tetraciclinas, eritromicina e estreptomicina ligam-se ao ribossomo 70S e travam a tradução na bactéria, sem reconhecer o 80S do citosol humano. No PAS 1 de 2021 (item 71), a inibição da síntese proteica foi a resposta de um item de múltipla escolha sobre o mecanismo de um antibiótico. Os alvos dos antibióticos estão em bactérias. Vale lembrar que uma célula sem núcleo não transcreve: o PAS 3 de 2022 (item 60) afirmou que “hemácias maduras não têm núcleo e, por isso, não há transcrição nessas células”, e o item é certo. Sem DNA nuclear não há molde; a hemácia vive da hemoglobina que fabricou antes de perder o núcleo.
Tradução
Síntese da cadeia de aminoácidos nos ribossomos, no citoplasma, a partir do RNAm, lido no sentido 5’→3’. Iniciação no AUG, com RNAt de metionina; alongamento pelos sítios A (entrada do RNAt), P (cadeia em crescimento) e E (saída), com ligação peptídica catalisada pelo RNAr; terminação num códon de parada, por fator de liberação. Vários ribossomos num mesmo RNAm formam um polissomo. Ribossomos livres e aderidos ao retículo são os mesmos; o endereço da proteína decide. 70S (bactérias, mitocôndrias, cloroplastos) e 80S (citosol eucariótico): alvo seletivo de antibióticos.
Da cadeia de aminoácidos à proteína que funciona
O que sai do ribossomo é um polipeptídeo: um fio de aminoácidos na ordem ditada pelos códons. Uma proteína é esse fio dobrado numa forma precisa, e a forma é que trabalha. O dobramento começa durante a própria tradução e é ajudado por proteínas chamadas chaperonas; a sequência de aminoácidos, com seus radicais hidrofóbicos e hidrofílicos, carregados e neutros, decide a forma final. Os níveis de estrutura e o que acontece quando a forma se perde estão em proteínas e enzimas.
Entre o polipeptídeo e a proteína pronta há ainda modificações que a tradução não faz. A metionina inicial pode ser removida. Trechos inteiros podem ser cortados: a insulina é traduzida como uma cadeia única, e só vira hormônio ativo depois que um pedaço do meio é retirado e as duas pontas ficam unidas por pontes de enxofre. Açúcares, fosfatos e lipídios podem ser acrescentados a aminoácidos específicos, em geral no retículo e no complexo golgiense. Várias cadeias podem se associar: a hemoglobina só funciona como conjunto de quatro cadeias, duas alfa e duas beta, cada uma produto de um gene diferente.
Daí sai uma correção à frase “um gene, uma proteína”. Ela foi uma boa hipótese de trabalho nos anos 1940, mas hoje tem exceções em todas as direções: um gene pode gerar várias proteínas (por splicing alternativo e por cortes diferentes), uma proteína pode exigir vários genes (a hemoglobina), e muitos genes não produzem proteína alguma, e sim RNAs funcionais. A frase correta é: um gene codifica um produto, e o produto pode ser uma proteína, parte de uma proteína ou um RNA.
Anemia falciforme: uma letra, um aminoácido, uma forma
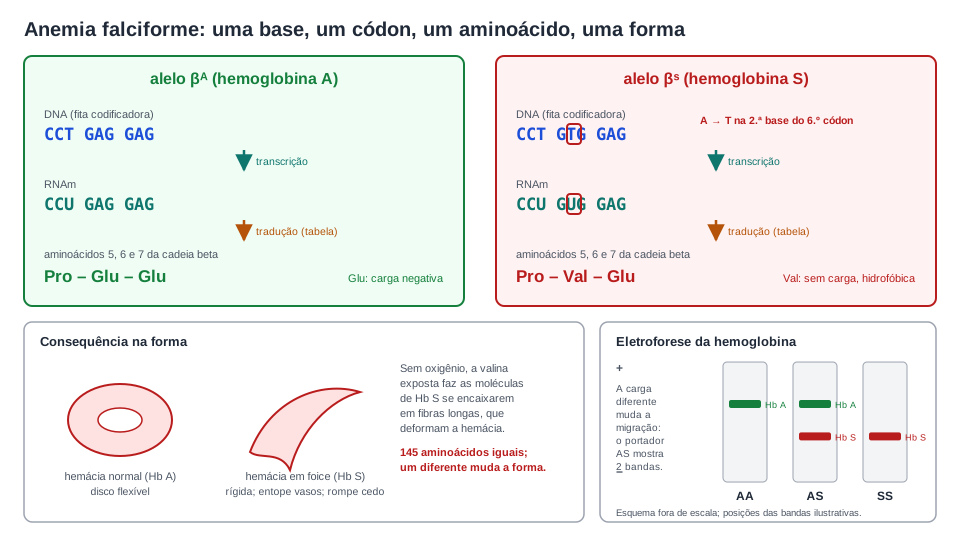
O exemplo que atravessa esta página de ponta a ponta é a hemoglobina S. O gene da cadeia beta da hemoglobina fica no cromossomo 11. No alelo comum, chamado βA, um trecho da fita codificadora é CCT GAG GAG. Transcrito, dá o RNA mensageiro CCU GAG GAG. Traduzido pela tabela, dá prolina, ácido glutâmico, ácido glutâmico: Pro-Glu-Glu, os aminoácidos 5, 6 e 7 da cadeia beta.
No alelo βS, a segunda base do segundo códon trocou de A por T: CCT GTG GAG. O RNA fica CCU GUG GAG, e a leitura fica Pro-Val-Glu. Na posição 6 da cadeia, um ácido glutâmico, que tem carga negativa e gosta de água, foi substituído por uma valina, sem carga e hidrofóbica. É só isso. As outras 145 posições são idênticas. (Os bancos de dados de variantes contam a metionina inicial, removida na proteína madura, e registram a mesma troca como posição 7; nos livros e na prova, é a posição 6.)
A consequência vem da forma. A valina na superfície da proteína cria um ponto pegajoso, e, quando a hemoglobina S perde o oxigênio, as moléculas se encaixam umas nas outras e formam fibras longas dentro da hemácia, que se deforma em foice. As hemácias em foice são rígidas, entopem vasos pequenos e se rompem cedo: dores, lesões e anemia. A troca de carga é também o que o hemocentro detecta: na eletroforese, a hemoglobina S migra de modo diferente da A, e uma pessoa com o traço falciforme (um alelo de cada) mostra as duas bandas.
Esta página mostra como a letra vira aminoácido. A troca de base como mutação, e por que ela é pontual e não silenciosa, está em mutações; a herança do alelo, o cruzamento AS × AS e a probabilidade de um filho SS estão em leis de Mendel; a estrutura da hemoglobina e o que a troca faz com a forma estão em proteínas e enzimas. O PAS 3 de 2022 dedicou um bloco à doença, com a tabela do gene impressa, e o item 61 dizia que a mutação “levou à alteração de um único aminoácido na proteína codificada por esse gene”. Certo: uma base, um códon, um aminoácido.
O circuito inteiro num caso real. Uma base trocada no gene da cadeia beta da hemoglobina atravessa a transcrição e a tradução e chega à proteína como um aminoácido trocado: ácido glutâmico, carregado, vira valina, hidrofóbica, na posição 6. A proteína com a valina se agrega quando perde oxigênio e deforma a hemácia; a diferença de carga é o que a eletroforese enxerga, e o portador AS mostra as duas bandas. Esquema fora de escala. Diagrama autoral.
Exemplo resolvido: o caminho inverso. Um laboratório sequencia a cadeia beta de uma pessoa e encontra valina na posição 6. Dá para afirmar que o códon no gene é GTG?
Não com certeza. A valina é codificada por GUU, GUC, GUA e GUG no RNA, logo o gene poderia ter GTT, GTC, GTA ou GTG. Na anemia falciforme, sabe-se que é GTG porque o gene foi sequenciado, e não porque a proteína o diz. É o item 107 de 2021 aplicado a um caso real: da proteína não se determina o gene.
Mesmo DNA, células diferentes: a regulação
Todas as células com núcleo de uma pessoa carregam o mesmo conjunto de genes. Um neurônio e uma célula do fígado têm o mesmo DNA e proteínas muito diferentes, porque cada uma expressa um subconjunto diferente de genes. Expressar um gene é transcrevê-lo e traduzi-lo. Um gene pode estar ligado, com muitos RNAs mensageiros e muita proteína, desligado, sem RNA algum, ou em qualquer nível entre os dois. É a regulação da expressão gênica, e ela acontece, sobretudo, no controle de quando a RNA-polimerase inicia a transcrição.
O operon lac, o primeiro interruptor descrito
Em bactérias, o modelo clássico é o operon lac de Escherichia coli, descrito por François Jacob e Jacques Monod em 1961, trabalho que lhes valeu o Nobel de 1965 (com André Lwoff). A bactéria tem três genes, em fila, para enzimas que digerem a lactose. Na ausência de lactose, uma proteína repressora fica presa ao DNA logo depois do promotor, numa região chamada operador, e bloqueia a passagem da RNA-polimerase: os genes ficam desligados. Quando há lactose, um derivado dela se liga ao repressor, que muda de forma e solta o DNA; a polimerase passa, e os três genes são transcritos num único RNA mensageiro. A bactéria só gasta energia fabricando as enzimas quando há o que digerir. A lógica é a de um interruptor que a presença do substrato liga.
Em eucariontes, muitas camadas
Nas células com núcleo, a regulação tem mais pontos de controle. Proteínas chamadas fatores de transcrição ligam-se a sequências perto do gene ou distantes dele e aumentam ou reduzem a frequência com que a RNA-polimerase inicia. O empacotamento da cromatina decide o acesso: um gene em cromatina compacta não é lido. Marcas químicas sobre o DNA e sobre as histonas, como a metilação de citosinas, mantêm genes desligados de modo estável, às vezes por muitas divisões celulares; é o campo da epigenética. O splicing alternativo, a duração do RNA mensageiro e a velocidade de degradação da proteína completam a lista.
O ponto que a prova cobra é a diferença entre regular e mutar. Ligar ou desligar um gene não troca letra alguma da sequência: a informação continua lá, só não é lida. O PAS 3 de 2010 (item 21), num texto sobre a metilação de bases que liga e desliga genes, afirmou que “o liga-desliga de genes do tipo citado no texto corresponde à mutação gênica e à consequente alteração das bases nitrogenadas modificadas”. Errado: a metilação é uma marca sobre a base, reversível, que altera a leitura e não a sequência. Mutação é alteração da sequência, assunto de mutações. E a pergunta que a regulação responde, como uma célula-tronco vira neurônio ou célula do fígado, está em núcleo e ciclo celular, na seção sobre diferenciação.
O mesmo genoma em dois ambientes
Gêmeos idênticos nascem com o mesmo DNA. Um estudo publicado em 2005 por Mario Fraga e colaboradores comparou as marcas epigenéticas de pares de gêmeos de várias idades e encontrou diferenças muito maiores entre gêmeos de 50 anos do que entre gêmeos de 3: com o passar dos anos, alimentação, tabagismo e outras experiências vão alterando a metilação do DNA de cada um. Nenhuma letra mudou; mudou o que é lido. É o mesmo tipo de mecanismo que faz uma abelha-rainha e uma operária, com genomas iguais, terem corpos tão diferentes: um estudo de 2008 mostrou que a dieta da larva altera a metilação do DNA e, com ela, o destino reprodutivo do inseto.
Expressão e regulação gênica
Expressão de um gene é sua transcrição e tradução; cada tipo celular expressa um subconjunto dos genes do genoma. Regulação é o controle de quanto cada gene é expresso: em bactérias, o operon lac (Jacob e Monod, 1961) liga os genes da lactose só quando há lactose, por um repressor que solta o DNA; em eucariontes, fatores de transcrição, compactação da cromatina, metilação e splicing. Regular não altera a sequência. Critério para itens: “ligar ou desligar um gene é mutação” está errado (PAS 3 2010, item 21).
O genoma humano em números
O genoma é o conjunto de todo o DNA de um organismo, genes e não genes. No ser humano, o genoma nuclear haploide tem cerca de 3,1 bilhões de pares de bases, distribuídos em 23 moléculas (os 23 cromossomos de um conjunto; uma célula diploide tem 46). Nele há cerca de 20 mil genes que codificam proteínas, segundo as anotações atuais do consórcio GENCODE, que contam entre 19 e 20 mil. Esses genes, somando só os éxons, ocupam entre 1 e 2 % do total. O restante são íntrons, sequências reguladoras, genes de RNAs que não codificam proteína, sequências repetidas e trechos sem função conhecida.
O PAS 3 de 2021 (item 106), num texto sobre a identificação de ossadas por DNA, afirmou: “Apenas uma pequena parte do genoma humano corresponde a genes.” Certo. É também a razão de os marcadores usados em testes de paternidade e em identificação forense ficarem fora dos genes: são trechos repetidos, muito variáveis entre pessoas e herdados metade de cada genitor. O método está na página futura sobre biotecnologia.
Dois números do passado continuam circulando e estão errados. Antes do sequenciamento, estimava-se que o ser humano tivesse 100 mil genes; a contagem real é cinco vezes menor. E o DNA que não codifica proteína já foi chamado de “DNA lixo”; a expressão foi abandonada porque boa parte dele regula a expressão dos genes, e um organismo não funciona sem ela.
O Projeto Genoma Humano, coordenado internacionalmente, começou em 1990, publicou o rascunho da sequência em 2001 e foi declarado concluído em abril de 2003, com mais de 90 % do genoma sequenciado; as regiões de repetições longas, como centrômeros e telômeros, ficaram fora porque os métodos da época não as resolviam. Só em 2022 o consórcio Telomere-to-Telomere publicou a primeira sequência humana realmente completa, de ponta a ponta de cada cromossomo. Sequenciar, amplificar DNA por PCR e recombinar genes entre espécies são as ferramentas de uma página própria sobre biotecnologia, ainda em preparação; aqui basta saber que todas elas dependem do que esta página explicou: pareamento de bases, polimerases e código universal.
Fora do núcleo, cada mitocôndria tem seu próprio DNA, circular, de 16 569 pares de bases e 37 genes, em várias cópias por organela, e cada célula tem centenas de mitocôndrias. O PAS 3 de 2008 (item 103), num texto sobre a reconstituição de uma mulher neandertal, afirmou que o DNA nuclear está presente “em, no máximo, duas cópias” por célula, enquanto o mitocondrial “está presente nessas células em maior abundância”, o que aumenta a chance de encontrá-lo em material antigo. Certo: duas cópias de cada gene nuclear, uma em cada homólogo, contra milhares de cópias do DNA mitocondrial. A origem bacteriana desse DNA está em endossimbiose. Bactérias, por sua vez, têm um cromossomo circular e, com frequência, plasmídeos, pequenos círculos de DNA com poucos genes, entre eles os de resistência a antibióticos: o PAS 3 de 2024 (item 48) pediu esse nome num item de múltipla escolha, e a célula bacteriana está em bactérias.
Mais genes não é mais complexidade
O genoma humano, com cerca de 3 bilhões de nucleotídeos, é pequeno perto do de algumas plantas: o da flor japonesa Paris japonica tem cerca de 150 bilhões, 50 vezes o humano, segundo o Instituto Nacional de Pesquisa do Genoma Humano dos Estados Unidos. E o número de genes de uma espécie não acompanha a complexidade do organismo. O que distingue os organismos não é a contagem de genes, e sim como e quando cada gene é usado, por splicing alternativo e por regulação.
Como ler sequências, tabelas e esquemas na prova
As questões de genética molecular vêm em quatro formatos, e cada um tem um protocolo.
Uma sequência de DNA para transcrever e traduzir. Primeiro identifique qual fita foi dada e em que orientação. Se é a fita molde, escreva o RNA complementar e antiparalelo, trocando A→U, T→A, G→C, C→G, e comece pela ponta 5’ do RNA. Se é a fita codificadora, copie trocando T por U. Depois procure o AUG, separe os códons de três em três a partir dele e consulte a tabela até o primeiro códon de parada. Conte os aminoácidos sem incluir a parada.
Uma tabela do código genético. Localize a linha pela primeira base, a coluna pela segunda e a posição pela terceira. Confira duas vezes códons que a prova costuma escolher: AUG, os três de parada, e os sinônimos do aminoácido envolvido na questão. Se a questão fala em “troca na terceira base”, teste se o novo códon é sinônimo.
Um esquema de processo. Em replicação, procure a forquilha, as duas fitas-molde e as fitas novas, e lembre que a nova sempre cresce 5’→3’. Em transcrição, procure a RNA-polimerase, o promotor e o RNA saindo de fita simples. Em tradução, procure o ribossomo, o RNAm, os RNAt com anticódons e a cadeia crescendo. O teste rápido para saber que processo o esquema mostra é o produto: DNA de fita dupla, replicação; RNA, transcrição; cadeia de aminoácidos, tradução.
Um texto-base com vocabulário. Itens de certo e errado em genética molecular costumam trocar uma palavra: replicação por transcrição, DNA por RNA, códon por anticódon, gene por genoma, degenerado por ambíguo, núcleo por citoplasma. Leia o item procurando a palavra trocada antes de julgar a frase inteira.
Exemplo resolvido: julgar quatro afirmações sobre o mesmo esquema. Um esquema mostra uma dupla hélice abrindo-se numa forquilha, com duas fitas novas sendo montadas. Julgue: (I) o esquema representa a transcrição; (II) as duas fitas novas crescem no sentido 5’→3’; (III) ao fim, cada molécula terá uma fita antiga e uma nova; (IV) a enzima que une as bases das fitas novas ao molde forma ligações de hidrogênio entre elas.
(I) Errado: duas fitas novas de DNA numa forquilha é replicação; a transcrição produz um único RNA. (II) Certo: toda polimerase alonga 5’→3’, e é por isso que uma das fitas é feita em fragmentos. (III) Certo: é a definição de semiconservativa. (IV) Errado: a DNA-polimerase forma ligações covalentes, as fosfodiéster, entre os nucleotídeos da fita nova. As ligações de hidrogênio entre cada base nova e a base do molde se formam por complementaridade, sem catálise. O item atribui à enzima a ligação errada, e esse é o tipo de troca de vocabulário que decide um item de certo e errado.
Erros que derrubam itens
“O RNA tem timina.” O RNA tem uracila no lugar da timina. Errado, e já foi item (PAS 3 2020, item 79).
“A tradução ocorre no núcleo.” A transcrição ocorre no núcleo; a tradução, nos ribossomos, no citoplasma. Em bactérias, as duas ocorrem no citoplasma, ao mesmo tempo.
“O DNA sai do núcleo para ser traduzido.” O DNA fica; o RNA mensageiro sai.
“O RNAm é lido de 3’ para 5’.” O ribossomo lê de 5’ para 3’, e a cadeia cresce do amino-terminal ao carboxi-terminal.
“Cada aminoácido tem um só códon.” Só metionina e triptofano. Os outros 18 têm de 2 a 6. O código é degenerado.
“O código é ambíguo.” Cada códon indica um único aminoácido. Degenerado e ambíguo são o oposto um do outro.
“O anticódon é igual ao códon.” É complementar e antiparalelo: códon 5’-AUG-3’, anticódon 3’-UAC-5’.
“Da proteína se deduz o gene.” Não: vários códons por aminoácido, e nenhuma enzima faz o caminho proteína → RNA (PAS 3 2021, item 107).
“A replicação é conservativa.” É semiconservativa: cada molécula nova tem uma fita antiga e uma nova (Meselson e Stahl, 1958).
“O retrovírus viola o dogma central, logo o dogma está errado.” RNA → DNA é transferência entre ácidos nucleicos, prevista por Crick. O que o dogma proíbe é proteína → ácido nucleico.
“O RNAm da vacina se integra ao DNA.” Não há transcriptase reversa na célula humana; o RNAm é traduzido no citoplasma e degradado (PAS 3 2020, item 77).
“Gene e proteína são um para um.” Um gene pode gerar várias proteínas por splicing alternativo; uma proteína pode exigir vários genes; muitos genes produzem só RNA.
“Íntrons são lixo.” Não codificam proteína, mas contêm sinais de splicing e regulação; mutações neles causam doença.
“Ligar ou desligar um gene é mutação.” Regulação não altera a sequência (PAS 3 2010, item 21).
“Humanos têm 100 mil genes.” Cerca de 20 mil codificadores de proteína, em 1 a 2 % do genoma (PAS 3 2021, item 106).
“Genoma é o mesmo que gene.” Genoma é todo o DNA; os genes são uma pequena parte dele.
“Erro de transcrição é herdado.” Um RNA errado é descartado; só a alteração no DNA de célula germinativa passa adiante.
“A regra de Chargaff vale para qualquer ácido nucleico.” Vale para fita dupla. Um RNA de fita simples pode ter A ≠ U.
O essencial em meia página
Nucleotídeo = fosfato + pentose + base. Purinas A e G (dois anéis); pirimidinas C, T e U (um anel). Fita com pontas 5’ (fosfato) e 3’ (hidroxila), unida por ligações fosfodiéster.
DNA: desoxirribose, A G C T, duas fitas antiparalelas em dupla hélice, pares A–T (2 ligações de H) e G–C (3). RNA: ribose, A G C U, fita simples (com exceções). Chargaff: A = T, G = C, A + G = T + C, só em fita dupla. 0,34 nm por par; 10 pares por volta de 3,4 nm; 2 nm de diâmetro; 3,1 bilhões de pares de bases ≈ 1 m por conjunto haploide, 2 m por célula diploide. Watson e Crick, Nature, 25/4/1953, com os dados de Franklin, Gosling e Wilkins; Nobel de 1962.
Replicação (fase S): semiconservativa (Meselson e Stahl, 1958). Helicase, primase e iniciador, DNA-polimerase 5’→3’ (Kornberg, Nobel de 1959), fita contínua e fragmentos de Okazaki, ligase. 2n moléculas após n rodadas, sempre 2 com fita original. Erros que escapam = mutações.
Dogma central (Crick, 1958 e 1970): DNA → RNA → proteína; RNA → DNA nos retrovírus (transcriptase reversa, Temin e Baltimore, 1970, Nobel de 1975); RNA → RNA em vírus de RNA; nunca proteína → ácido nucleico.
Transcrição: RNA-polimerase, promotor, fita molde lida 3’→5’, RNA 5’→3’ igual à fita codificadora com U. Eucariontes: cap, cauda poli-A, splicing (íntrons fora, éxons emendados; Sharp e Roberts, 1977, Nobel de 1993), splicing alternativo. O DNA não sai do núcleo.
RNAm leva a mensagem; RNAt traz o aminoácido e pareia pelo anticódon (complementar e antiparalelo ao códon); RNAr forma o ribossomo e catalisa a ligação peptídica.
Código genético: 64 códons = 4³; AUG início e metionina; UAA, UAG, UGA parada; 61 codificam 20 aminoácidos. Degenerado, não ambíguo, quase universal, lido sem sobreposição. Nirenberg e Matthaei, 1961 (poli-U → fenilalanina); Nobel de 1968 com Khorana e Holley. n bases até a parada → n/3−1 aminoácidos.
Tradução: no citoplasma, RNAm lido 5’→3’; iniciação no AUG, alongamento pelos sítios A, P e E, terminação no códon de parada; polissomo; ribossomos livres e do retículo; 70S × 80S e antibióticos.
Depois da tradução: dobramento, cortes, modificações, associação de cadeias. Um gene, um produto; não “uma proteína”.
Hemoglobina S: CCT GAG GAG → CCT GTG GAG; CCU GAG GAG → CCU GUG GAG; Pro-Glu-Glu → Pro-Val-Glu. Uma base, um códon, um aminoácido, uma forma.
Regulação: mesmo DNA, genes expressos diferentes; operon lac (Jacob e Monod, 1961, Nobel de 1965); fatores de transcrição, cromatina, metilação. Regular não é mutar.
Genoma humano: 3,1 bilhões de pares de bases, cerca de 20 mil genes codificadores em 1 a 2 % do total; Projeto Genoma Humano 1990–2003, sequência completa em 2022. DNA mitocondrial: 16 569 pares de bases, 37 genes, muitas cópias. “DNA lixo” e “100 mil genes” são ideias abandonadas.
Exercícios temporariamente indisponíveis
Não foi possível consultar o banco de questões. O conteúdo da aula continua disponível.
Flashcards temporariamente indisponíveis
Não foi possível consultar os cartões de revisão.
DNA e RNA [ácidos nucleicos] - Aula 08 - Módulo 1: Bioquímica - Prof. Guilherme
Prof. Guilherme Goulart - Biologia · 12:22
Introdução. Em 12 minutos, a aula apresenta o DNA e o RNA, suas estruturas e componentes (nucleotídeos, bases nitrogenadas e pentoses) e insiste na comparação entre as duas moléculas dentro de um contexto funcional, como a descrição do próprio autor resume. Corresponde às seções “Nucleotídeo: a peça que se repete”, “DNA e RNA: cinco diferenças que decidem itens” e “Dupla hélice: por que A com T e C com G”. Assista antes de ler e confira, ao fim, se consegue reproduzir a tabela de diferenças sem olhar.
REPLICAÇÃO (DUPLICAÇÃO) DO DNA | Biologia com Samuel Cunha
Biologia com Samuel Cunha · 21:25
Aprofundamento na replicação. A aula de 21 minutos segue, passo a passo, o roteiro listado na própria descrição: a helicase separa as fitas e forma a forquilha, cada fita serve de molde, a primase monta o iniciador de RNA, a DNA-polimerase adiciona nucleotídeos no sentido 5’→3’, uma fita é contínua e a outra fragmentada, os iniciadores são removidos e a ligase conecta os fragmentos. É a seção “Replicação: cada fita é molde da outra” com as enzimas em movimento. Veja depois de ler o experimento de Meselson e Stahl e tente prever cada etapa antes que ela apareça.
Tradução (síntese proteica) e código genético - Aula 12 - Módulo 1: Bioquímica - Prof. Guilherme
Prof. Guilherme Goulart - Biologia · 21:45
Aplicação: a tradução e o uso da tabela. Em 22 minutos, a aula mostra a síntese proteica no citoplasma com RNA mensageiro, RNA transportador, ribossomo e aminoácidos, e explica, nas palavras da descrição, o código genético universal e degenerado, seu significado e como usar a tabela. Cobre as seções “O código genético: 64 códons para 20 aminoácidos” e “Tradução: o ribossomo lê de três em três”. Pause na tabela e traduza você mesmo as sequências dos exemplos resolvidos da página antes de ver a resposta.
5 QUESTÕES PARA APRENDER DNA E RNA
Biologia com Patrick Gomes · 14:53
Resolução de questões. Em 15 minutos, o professor resolve cinco questões sobre ácidos nucleicos, DNA e RNA, com o objetivo declarado de tirar dúvidas comuns do conteúdo. Use depois das seções “Como ler sequências, tabelas e esquemas na prova” e “Erros que derrubam itens”: resolva cada questão antes de ouvir a resolução e marque quais erros da lista da página apareceram nas alternativas.
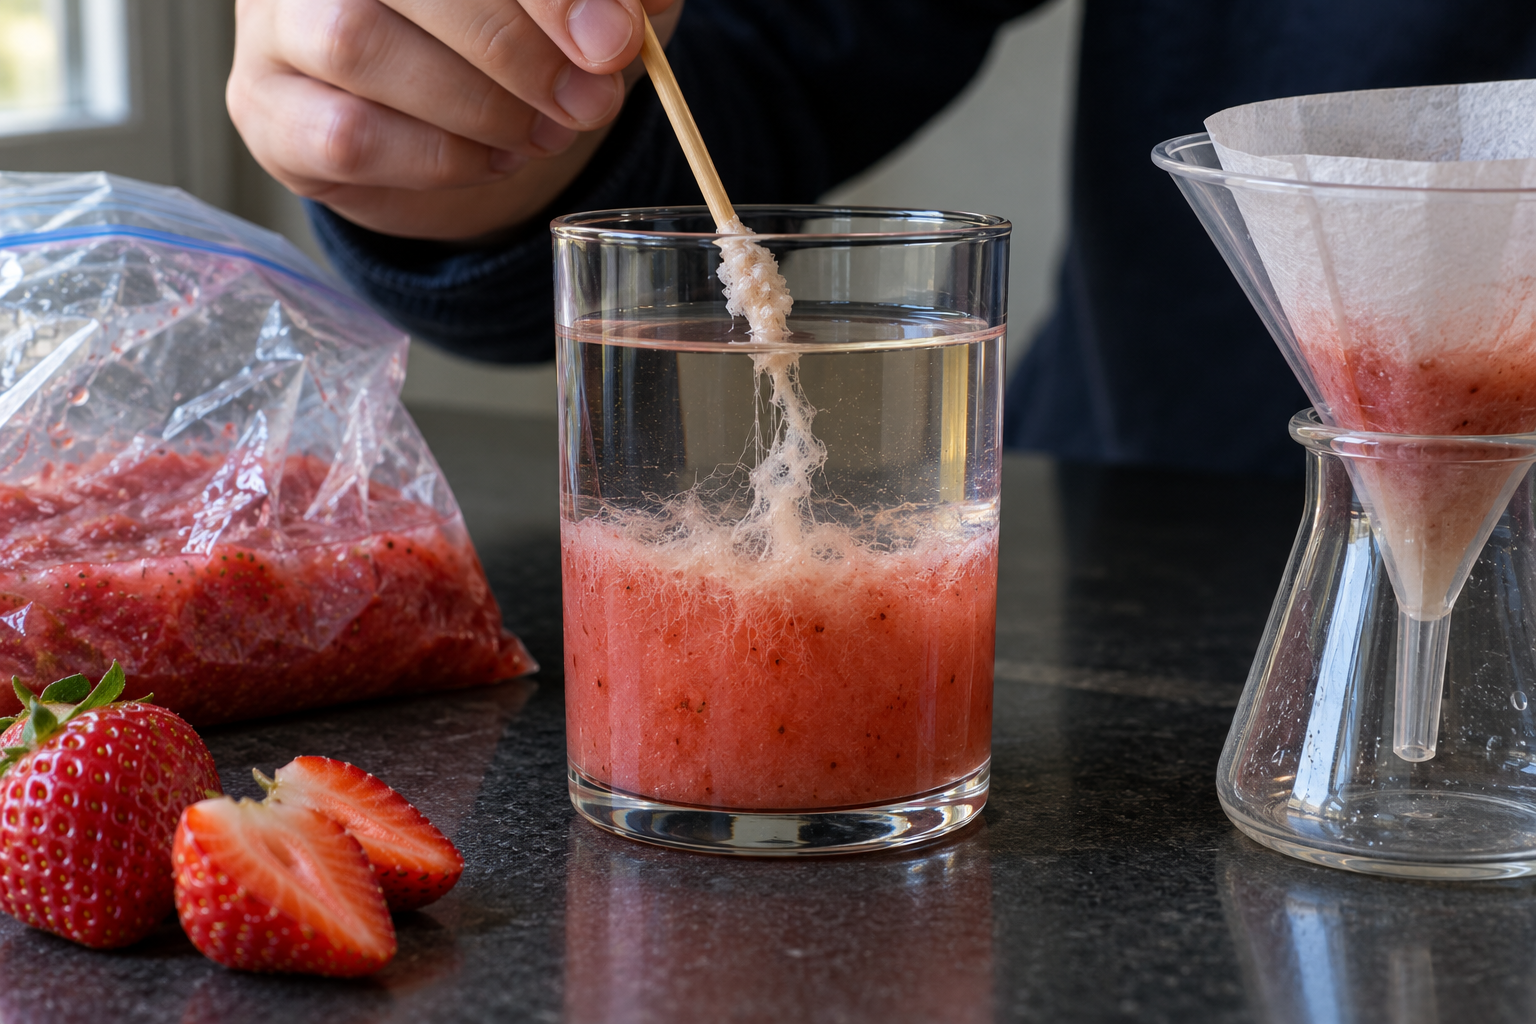
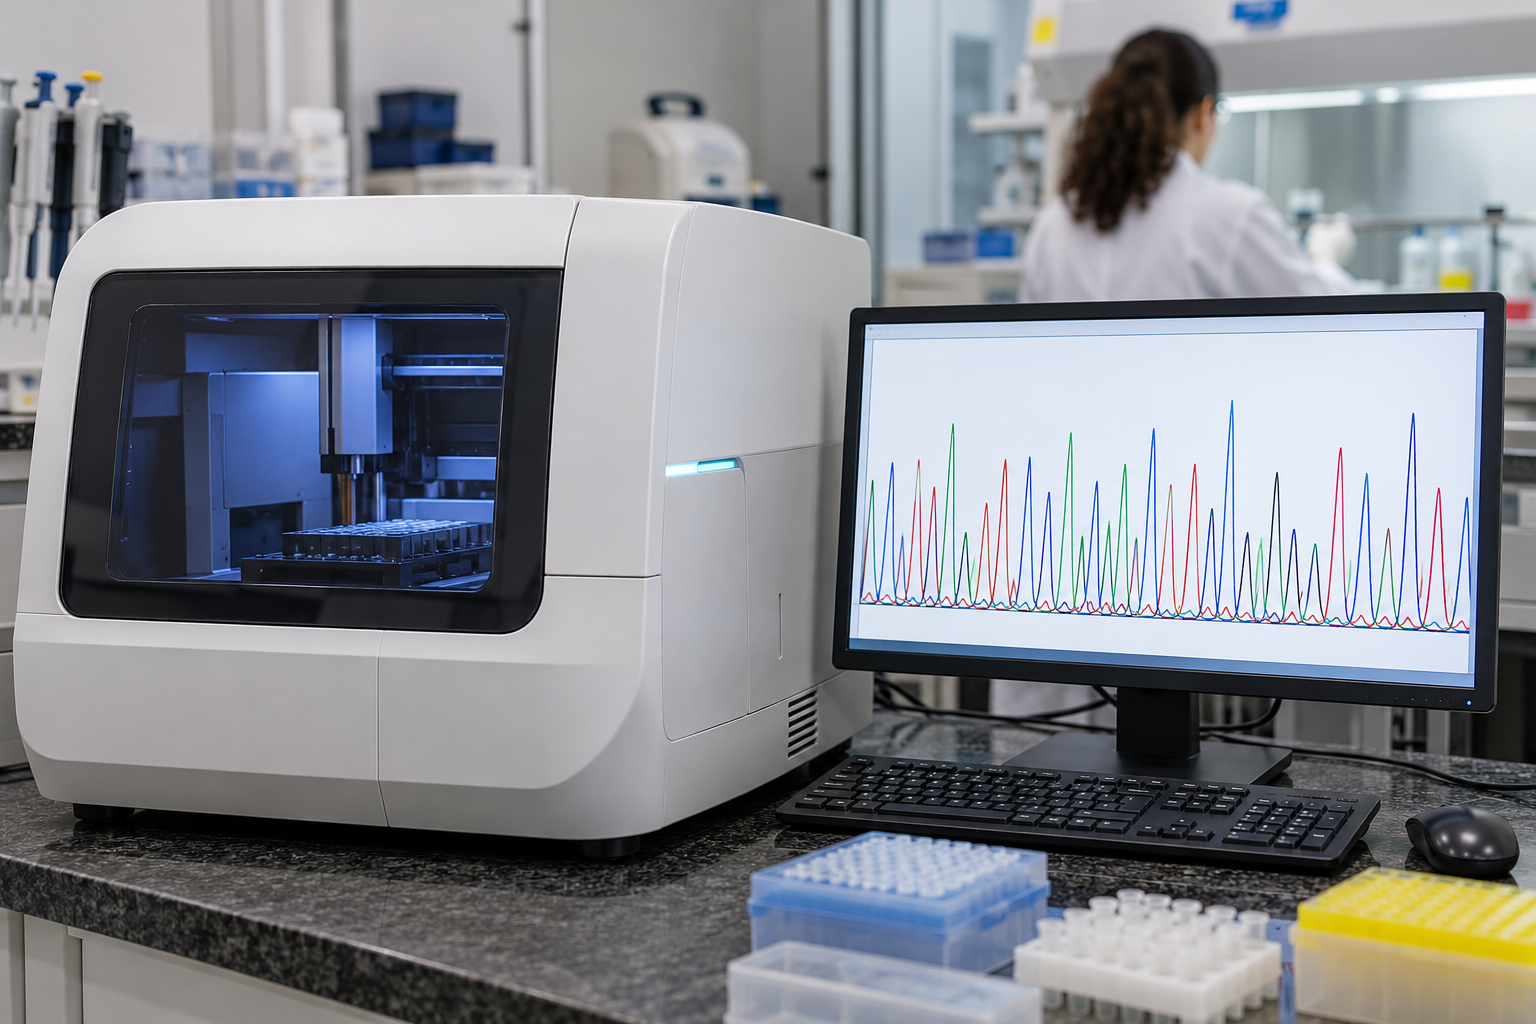
Na tradução, o ribossomo participa da montagem de um polipeptídeo a partir da informação presente no RNA mensageiro. Cores e tamanhos são esquemáticos.A peça e a escada. Cada nucleotídeo é fosfato, pentose e base, e os nucleotídeos se ligam pelo fosfato do carbono 5’ de um à hidroxila do 3’ do seguinte. Na dupla hélice, as duas fitas correm em sentidos opostos e cada degrau é uma purina com uma pirimidina, A com T por duas ligações de hidrogênio e G com C por três. A hélice está desenhada plana e fora de escala. Diagrama autoral.Como o DNA se copia e como se soube que a cópia é semiconservativa. Na forquilha, a helicase separa as fitas e cada uma serve de molde; como a DNA-polimerase só alonga no sentido 5’→3’, uma fita nova cresce contínua e a outra em fragmentos de Okazaki, iniciados por trechos de RNA e emendados pela ligase. Nos tubos de Meselson e Stahl, a banda única intermediária da primeira geração descarta o modelo conservativo, e as duas bandas da segunda descartam o dispersivo. Esquema fora de escala. Diagrama autoral.O fluxo da informação em sequência. Nas células, DNA é copiado em DNA, transcrito em RNA e traduzido em proteína. Em vírus, RNA pode ser copiado em DNA pela transcriptase reversa e RNA em RNA por uma polimerase viral, transferências entre ácidos nucleicos que a formulação de Crick admite. O que nunca foi observado é a volta: de uma proteína não se escreve um gene, e é isso que o dogma proíbe. Diagrama autoral.Do gene ao RNA mensageiro maduro. A RNA-polimerase se liga ao promotor, lê a fita molde no sentido 3’→5’ e monta um RNA igual à fita codificadora, com U no lugar de T. Em eucariontes, o pré-RNAm ganha o cap na ponta 5’ e a cauda poli-A na ponta 3’ e perde os íntrons; os éxons emendados saem pelo poro nuclear, e o DNA fica no núcleo. Esquema fora de escala. Diagrama autoral.Os 64 códons e seus significados. A primeira base escolhe a linha, a segunda a coluna, a terceira a posição dentro da célula. AUG inicia a leitura e codifica metionina; UAA, UAG e UGA encerram; os outros 61 códons codificam 20 aminoácidos, quase todos por mais de um códon, e os sinônimos costumam diferir só na terceira base. Diagrama autoral.Um ciclo de alongamento visto de dentro. O RNAt do sítio P segura a cadeia; o RNAt que chega ao sítio A traz o aminoácido do códon seguinte, pareado pelo anticódon; o ribossomo forma a ligação peptídica, avança três bases e libera o RNAt vazio pelo sítio E. A leitura começa no AUG e termina num códon de parada, e vários ribossomos lendo o mesmo RNAm formam um polissomo. Esquema fora de escala. Diagrama autoral.O circuito inteiro num caso real. Uma base trocada no gene da cadeia beta da hemoglobina atravessa a transcrição e a tradução e chega à proteína como um aminoácido trocado: ácido glutâmico, carregado, vira valina, hidrofóbica, na posição 6. A proteína com a valina se agrega quando perde oxigênio e deforma a hemácia; a diferença de carga é o que a eletroforese enxerga, e o portador AS mostra as duas bandas. Esquema fora de escala. Diagrama autoral.Mensageiro, transportador e ribossômico. O RNAm carrega os códons; o RNAt faz a correspondência entre códon e aminoácido pelo anticódon, complementar e antiparalelo; o RNAr, com proteínas, forma o ribossomo e catalisa a ligação peptídica. Todos nascem da transcrição, e só o mensageiro é traduzido. Esquemas fora de escala. Diagrama autoral.O RNA transportador associa o reconhecimento de um códon ao aminoácido transportado. Códons de parada não acrescentam um aminoácido.Após a tradução, dobramento e modificações podem ser necessários para a função da proteína. O modelo não representa uma sequência específica.Transcrição produz RNA usando uma fita de DNA como molde. Não é a etapa de montagem dos aminoácidos.DNA celular típico possui duas fitas complementares; RNA pode formar regiões pareadas por dobramento da própria fita.No processamento de muitos RNAs precursores, íntrons são removidos e éxons são unidos. O desenho representa segmentos, sem escala molecular.Numa vacina de RNA mensageiro, as células do músculo traduzem o RNA e fabricam uma proteína do vírus por alguns dias. O RNA é degradado e o DNA da pessoa não muda.Hemácias em foice entre hemácias normais. A forma vem de fibras de hemoglobina S dentro da célula, e a hemoglobina S vem de um único aminoácido trocado, que vem de uma única base trocada no gene.O fio esbranquiçado que sobe para o álcool é DNA de milhões de células de morango, com proteínas e RNA agregados. A mesma molécula, com as mesmas quatro letras, está em cada ser vivo.Representação didática de difração de raios X. Um padrão em X numa chapa de raios X é a assinatura de uma hélice. Foi esse tipo de imagem, obtida no laboratório de Rosalind Franklin em 1952, que permitiu deduzir o passo da hélice e a distância entre as bases.Representação didática de separação por densidade. Bandas em alturas diferentes num tubo de centrífuga separam DNA pesado, intermediário e leve. Foi assim que Meselson e Stahl mostraram, em 1958, que cada molécula nova guarda uma fita antiga.Picos em quatro cores, uma para cada base: é assim que um sequenciador lê a ordem das letras de um gene. Com ela, e com a tabela do código, sabe-se a proteína; o caminho inverso, da proteína ao gene, não existe.A eletroforese separa proteínas pela migração num campo elétrico. A hemoglobina S, com um aminoácido trocado, corre diferente da hemoglobina A, e o portador do traço falciforme mostra duas bandas.
Rota PAS 3
Genética e biotecnologia: a letra que muda tudo · PAS 3
Fontes desta página
Os materiais abaixo contribuíram para a explicação e os exemplos deste assunto.
Rota PAS 3 — Genética e biotecnologia: a letra que muda tudo · Antes de começar: dez minutos de aquecimento (DNA, gene, cromossomo; proteína como sequência de aminoácidos; códon); Do gene à proteína: como uma sequência de letras vira uma molécula (transcrição, tradução, código degenerado, gene × genoma, expressão gênica; exemplo guia CCT GAG GAG → CCT GTG GAG; itens 2020/80, 2020/78, 2021/106, 2021/107, 2012/27, 2009/85, 2008/103, 2010/21, 2024/48); Banco de treino T5 (PAS 3 2020/77, item da página de vacinas e soros)
Fonte principal do recorte e dos itens reais da página. As seções de mutações, genética clássica, heredogramas e biotecnologia e o bloco da anemia falciforme de 2025 pertencem às páginas de mutações, leis de Mendel e biotecnologia. A página acrescenta, ausentes do capítulo: estrutura do nucleotídeo e da dupla hélice, Chargaff, replicação e Meselson e Stahl, dogma central e exceções, processamento do RNA, tabela do código genético e sua leitura, etapas da tradução, operon lac e genoma em números.
Rota PAS 3 — Citologia e bioquímica: a célula em funcionamento · De que a vida é feita (arquitetura do DNA: ligação covalente base–açúcar, ligações de hidrogênio entre bases; item 2010/22; menção ao item 2020/79); Banco de treino T14 (PAS 3 2020/79, reproduzido com fonte)
Fonte dos itens reais 2010/22 (estrutura do DNA) e 2020/79 (bases do RNA), que o capítulo reproduz e nenhuma outra página havia gravado. O item 2022/60 (hemácias sem núcleo, sem transcrição) pertence à página de núcleo e ciclo celular e é reusado por GUID.
Biologia EM1 — Capítulo 4: A química da vida II (ácidos nucleicos) · Ácidos nucleicos: a molécula da informação (nucleotídeo, pentoses, bases, dupla hélice, complementaridade, Chargaff, fotografia 51 e artigo de 1953, RNA e ATP; resolvido de Chargaff); Onde há DNA? (genoma humano em números, DNA mitocondrial, plasmídeos; o que é um gene)
Fonte da estrutura das seções de nucleotídeo, DNA × RNA e dupla hélice e dos números do genoma. Datas e números reconferidos em fontes primárias (Nature 1953, Experientia 1950, PNAS 1958 e 1961, Nobel Prize, NHGRI, GENCODE, NCBI); onde o capítulo e as fontes concordam, a página segue ambos.
Biologia EM1 — Capítulo 8: Núcleo, cromossomos e divisão celular · Fase S e replicação; Como se soube que a cópia é semiconservativa: Meselson e Stahl, 1958
Fonte da remissão à fase S e do enquadramento do experimento de Meselson e Stahl. O ciclo celular e a cromatina ficam na página de núcleo e ciclo celular.
Biologia EM1 — Capítulo 5: Procariontes, eucariontes e endossimbiose · Tabela de organelas (ribossomos 70S e 80S); antibióticos e o ribossomo 70S
Fonte da distinção 70S × 80S usada na seção de tradução; a estrutura do ribossomo e dos retículos fica na página de organelas.